这篇是 3Blue1Brown 系列 Compression is Intelligence 的第二篇。Part 1 把熵重新讲了一遍,这里直接接上:熵之后,语言模型的损失函数到底是什么,以及为什么是它。原文链接:But what is cross-entropy? — Compression is Intelligence Part 2(B站官方双语版)。这个视频的讲解让我对交叉熵有了完全不一样的认识,妙不可言啊。
一、从一个20年前的实验说起
故事要从一篇 2002 年的论文《Language Trees and Zipping》开始。它做的事情相当离谱:把一堆不同语言写的文本扔进通用压缩器(gzip),看压缩之后的文件大小,就能把语言分好类、甚至恢复出语言的谱系树。
没有训练,没有词典,没有统计任何词频,甚至连语言学先验都不需要。只靠压缩。
这个想法很值得琢磨:压缩器为什么能看出语言关系?因为它本质上在估计数据的统计规律——一份文本能被压得多狠,取决于它有多”可预测”。两种语言越像,拿 A 的上下文去压 B,压缩比就会越接近单独压 A。
换句话说,“压缩距离”天然就是一个分布之间的差异度量。这个度量后面会变成一个名字:交叉熵。
不过先说好,视频里自己也提了:压缩距离不是严格的交叉熵,gzip 也远没达到 Shannon 极限,这只是一个经验估计。但方向是对的,而这一步足够把我们从”压缩”带到”语言模型训练”门口。
二、编码一个玩具消息
自然语言的分布复杂到没法描述,所以视频从一个玩具例子起步:给一个远程机器人发指令,只有四种符号——上、下、左、右。
第一版分布(也就是老规矩):
| 符号 | 概率 |
|---|---|
| 上 | 1/2 |
| 下 | 1/4 |
| 左 | 1/8 |
| 右 | 1/8 |
Part 1 已经推过结论:最优编码里,每个符号分配的比特数就是 −log₂(概率)。
| 符号 | 概率 | 比特数 |
|---|---|---|
| 上 | 1/2 | 1 |
| 下 | 1/4 | 2 |
| 左 | 1/8 | 3 |
| 右 | 1/8 | 3 |
−log₂ 这个形式第一次看到确实别扭。Shannon 把它叫做事件的信息量。Grant 甚至开玩笑说,希望历史上把它叫作 log base 1/2(即以 1/2 为底的对数),因为它其实就是在问”把东西对折几次,才能折到这么多”。
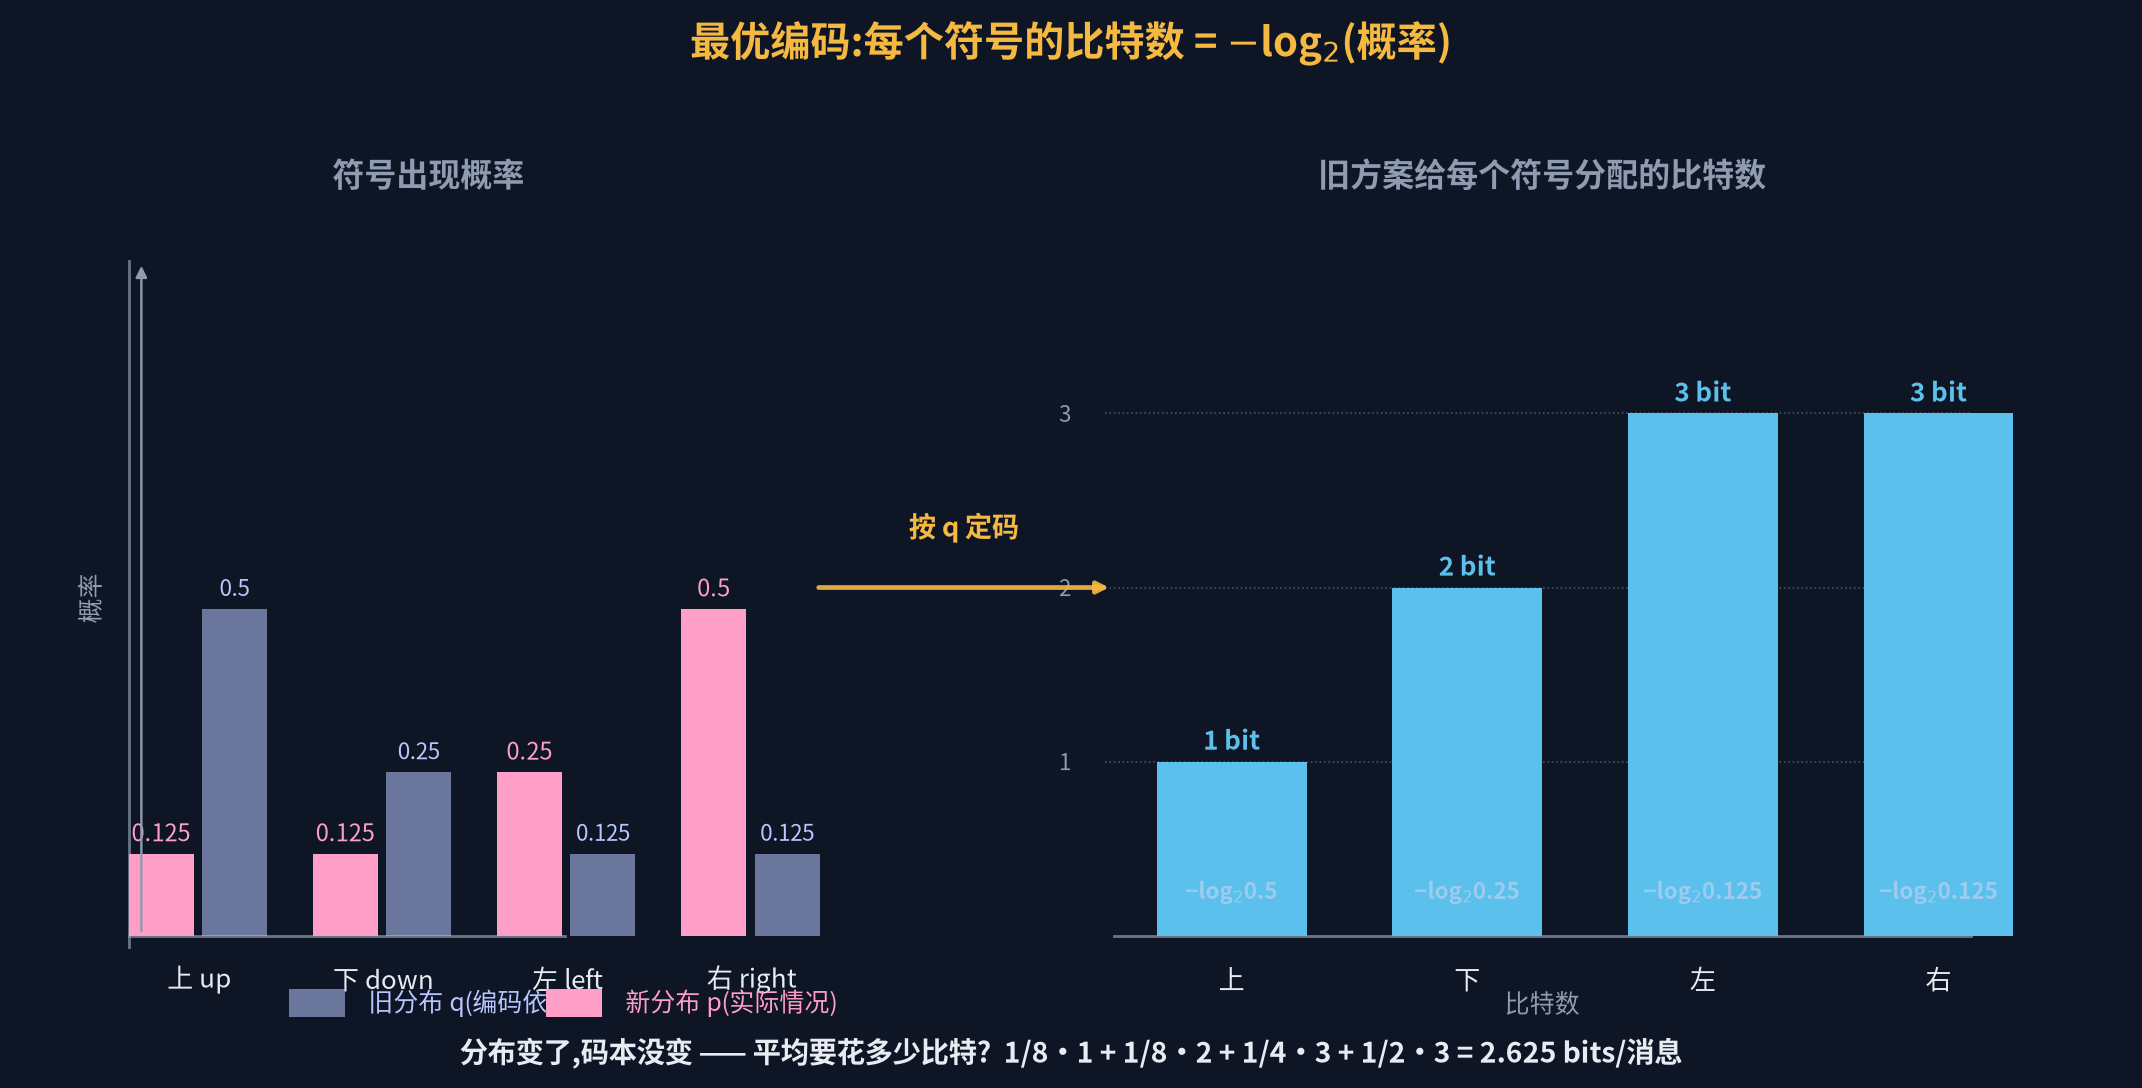
然后计划改了。从此刻起,新的分布是:
| 符号 | 概率 |
|---|---|
| 上 | 1/8 |
| 下 | 1/8 |
| 左 | 1/4 |
| 右 | 1/2 |
注意这句:编码和解码系统都写死了,用的是旧分布的最优方案。
于是每次发消息要花多少比特?加权求和:
1/8 · 1 + 1/8 · 2 + 1/4 · 3 + 1/2 · 3 = 2.625 bits / 消息
2.625 这个数,就是旧分布相对于新分布的交叉熵。
它回答的问题很具体:一个为某种上下文优化的压缩方案,换个上下文还能用吗?能用,但要多花多少?
三、交叉熵公式
把符号一般化:真实分布记作 p(实际发生的是什么),编码所依据的分布记作 q(我们按什么方案编码)。
H(p || q) = -Σ pᵢ log₂ qᵢ = Σ pᵢ · (-log₂ qᵢ)
每一项 −log₂ qᵢ 是”按 q 给符号 i 定的价”,乘上 pᵢ 是”这个符号实际出现的频率”,加起来就是平均要花的比特数。
写代码的话:
import numpy as np

p = np.array([0.125, 0.125, 0.25, 0.5])   # 真实分布(新)
q = np.array([0.5, 0.25, 0.125, 0.125])   # 编码所用分布(旧码本)

cross_entropy = -(p * np.log2(q)).sum()     # 2.625
entropy_p     = -(p * np.log2(p)).sum()     # 1.75
kl            = cross_entropy - entropy_p    # 0.875
三个数,后面全用得上。
四、p 和 q 不能对调
只留两个事件的分布,交叉熵的性质看得更清楚。
情形 A:q 是均匀分布(50/50),p 是偏斜的(90/10)。
0.9 × (-log₂ 0.5) + 0.1 × (-log₂ 0.5) = 0.9·1 + 0.1·1 = 1.00 bits
情形 B:反过来,q 偏斜(90/10),p 均匀(50/50)。
0.5 × (-log₂ 0.9) + 0.5 × (-log₂ 0.1) = 0.5·0.15 + 0.5·3.32 ≈ 1.74 bits
同样是 90/10 和 50/50 这两个分布,只是换了个角色,1 bit 直接变成 1.74 bits。
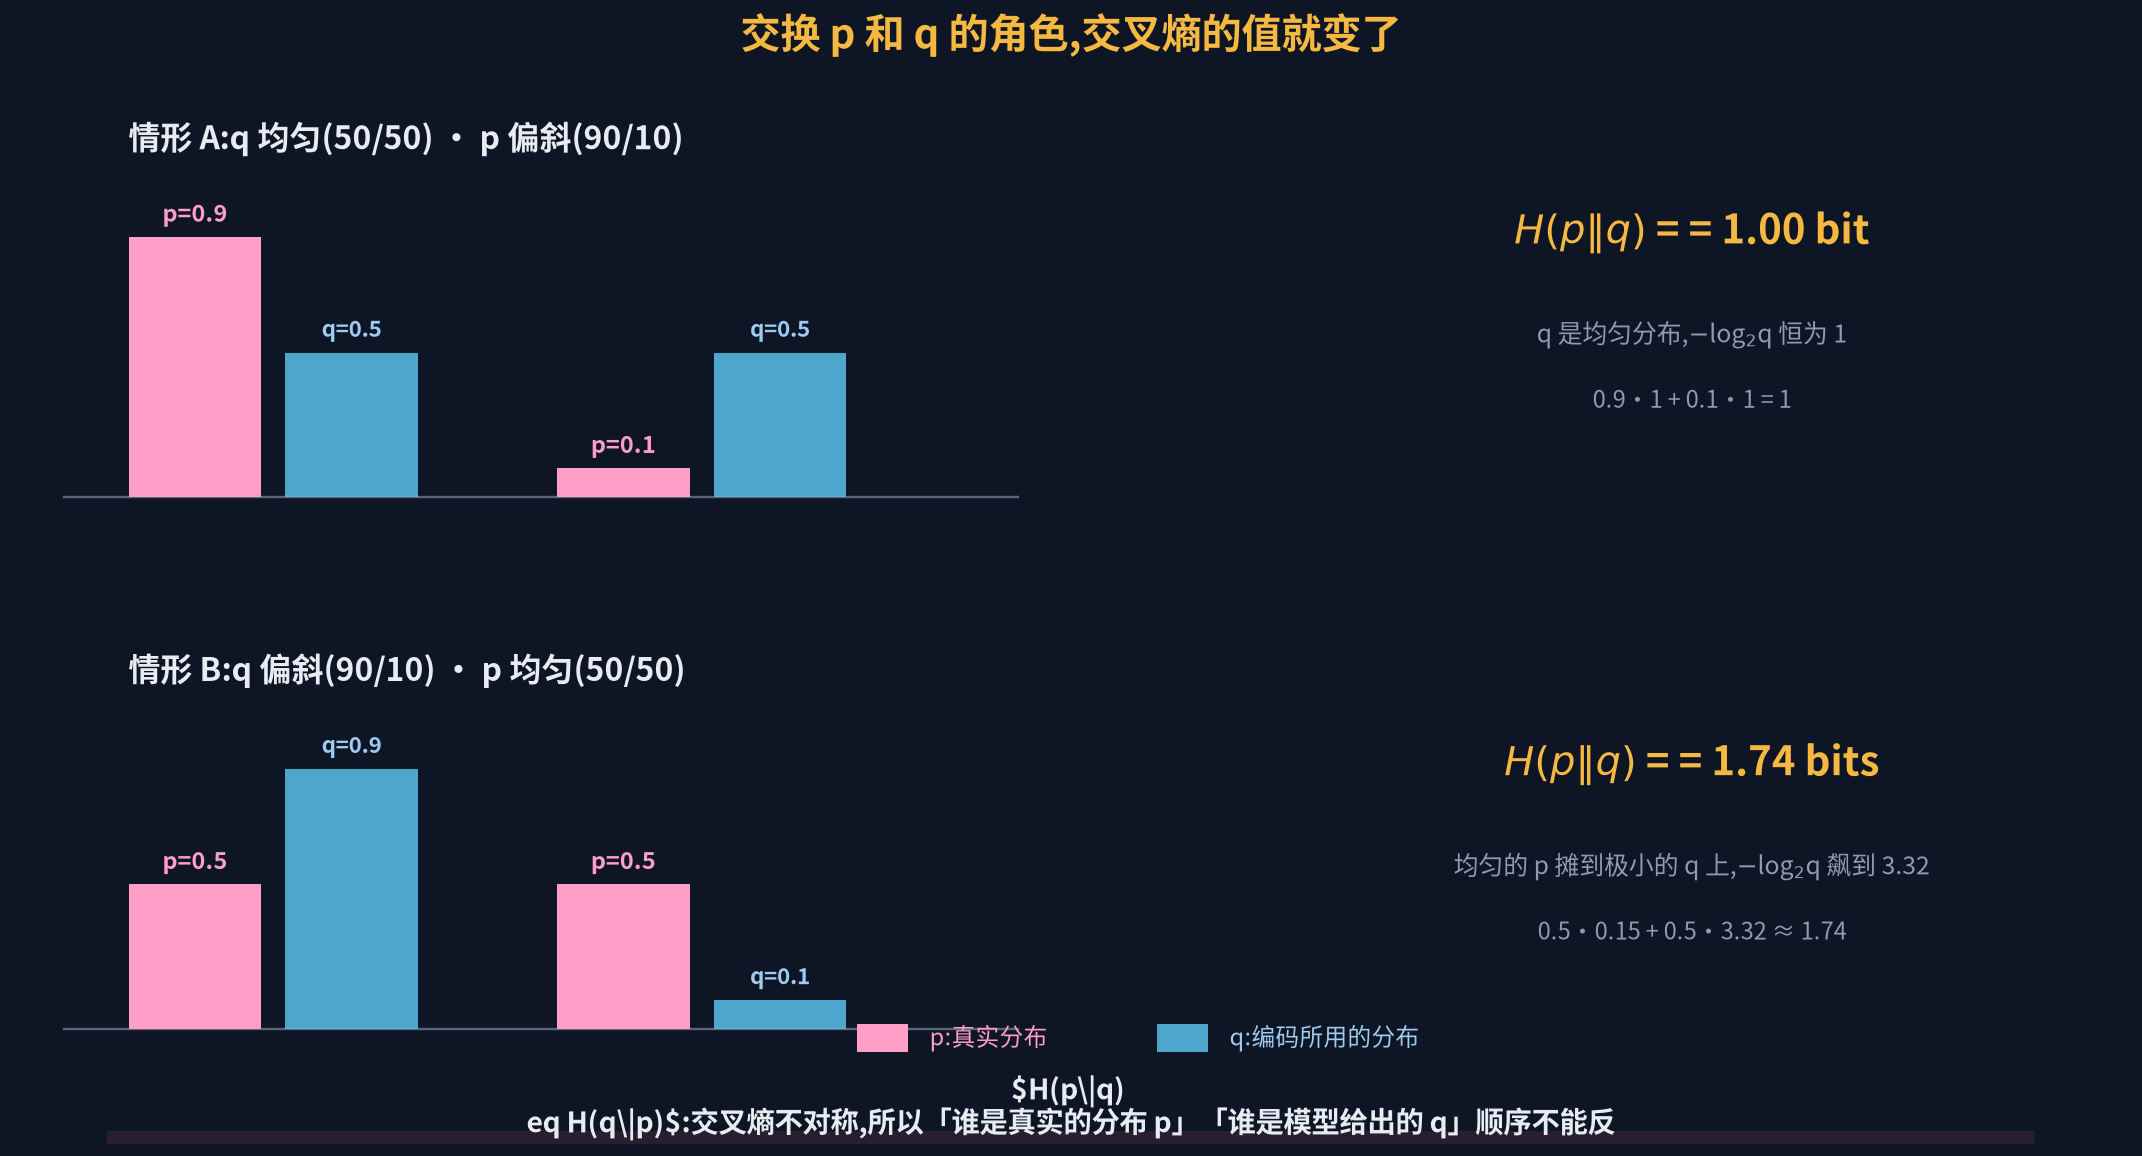
原因在 −log₂ q 这个”单价”上。q 偏斜意味着有个符号被定价成 3.32 bits;当 p 也均匀地往那个符号上摊 50% 的质量时,3.32 就被拉进了平均值。反过来 q 均匀时,所有符号单价都是 1,不管 p 长什么样,加权平均都等于 1。
所以 H(p||q) ≠ H(q||p)。写代码的时候,p 传错就出 bug。在语言模型里:p 是真实数据(下一个 token 到底是什么),q 是模型给的预测分布。顺序反了,你算的根本不是同一个东西。
五、最低点就是熵
把 p 钉死,让 q 动起来看交叉熵怎么变。
import numpy as np

p = np.array([0.125, 0.125, 0.25, 0.5])       # 固定真实分布
q_old = np.array([0.5, 0.25, 0.125, 0.125])   # 旧码本

ts = np.linspace(0, 1, 200)                   # q 从 p 走向 q_old
ce = np.array([-(p * np.log2((1-t)*p + t*q_old)).sum() for t in ts])

print(f"q=p 时: {ce[0]:.4f}   (= p 的熵)")     # 1.75
print(f"q=旧码本: {ce[-1]:.4f}")              # 2.625
print(f"差值(KL): {ce[-1] - ce[0]:.4f}")      # 0.875
q=p 时: 1.7500   (= p 的熵)
q=旧码本: 2.6250
差值(KL): 0.8750
曲线从下往上爬,最低点严格出现在 q = p 处,而那个最低值就是 p 的熵 H(p) = 1.75。
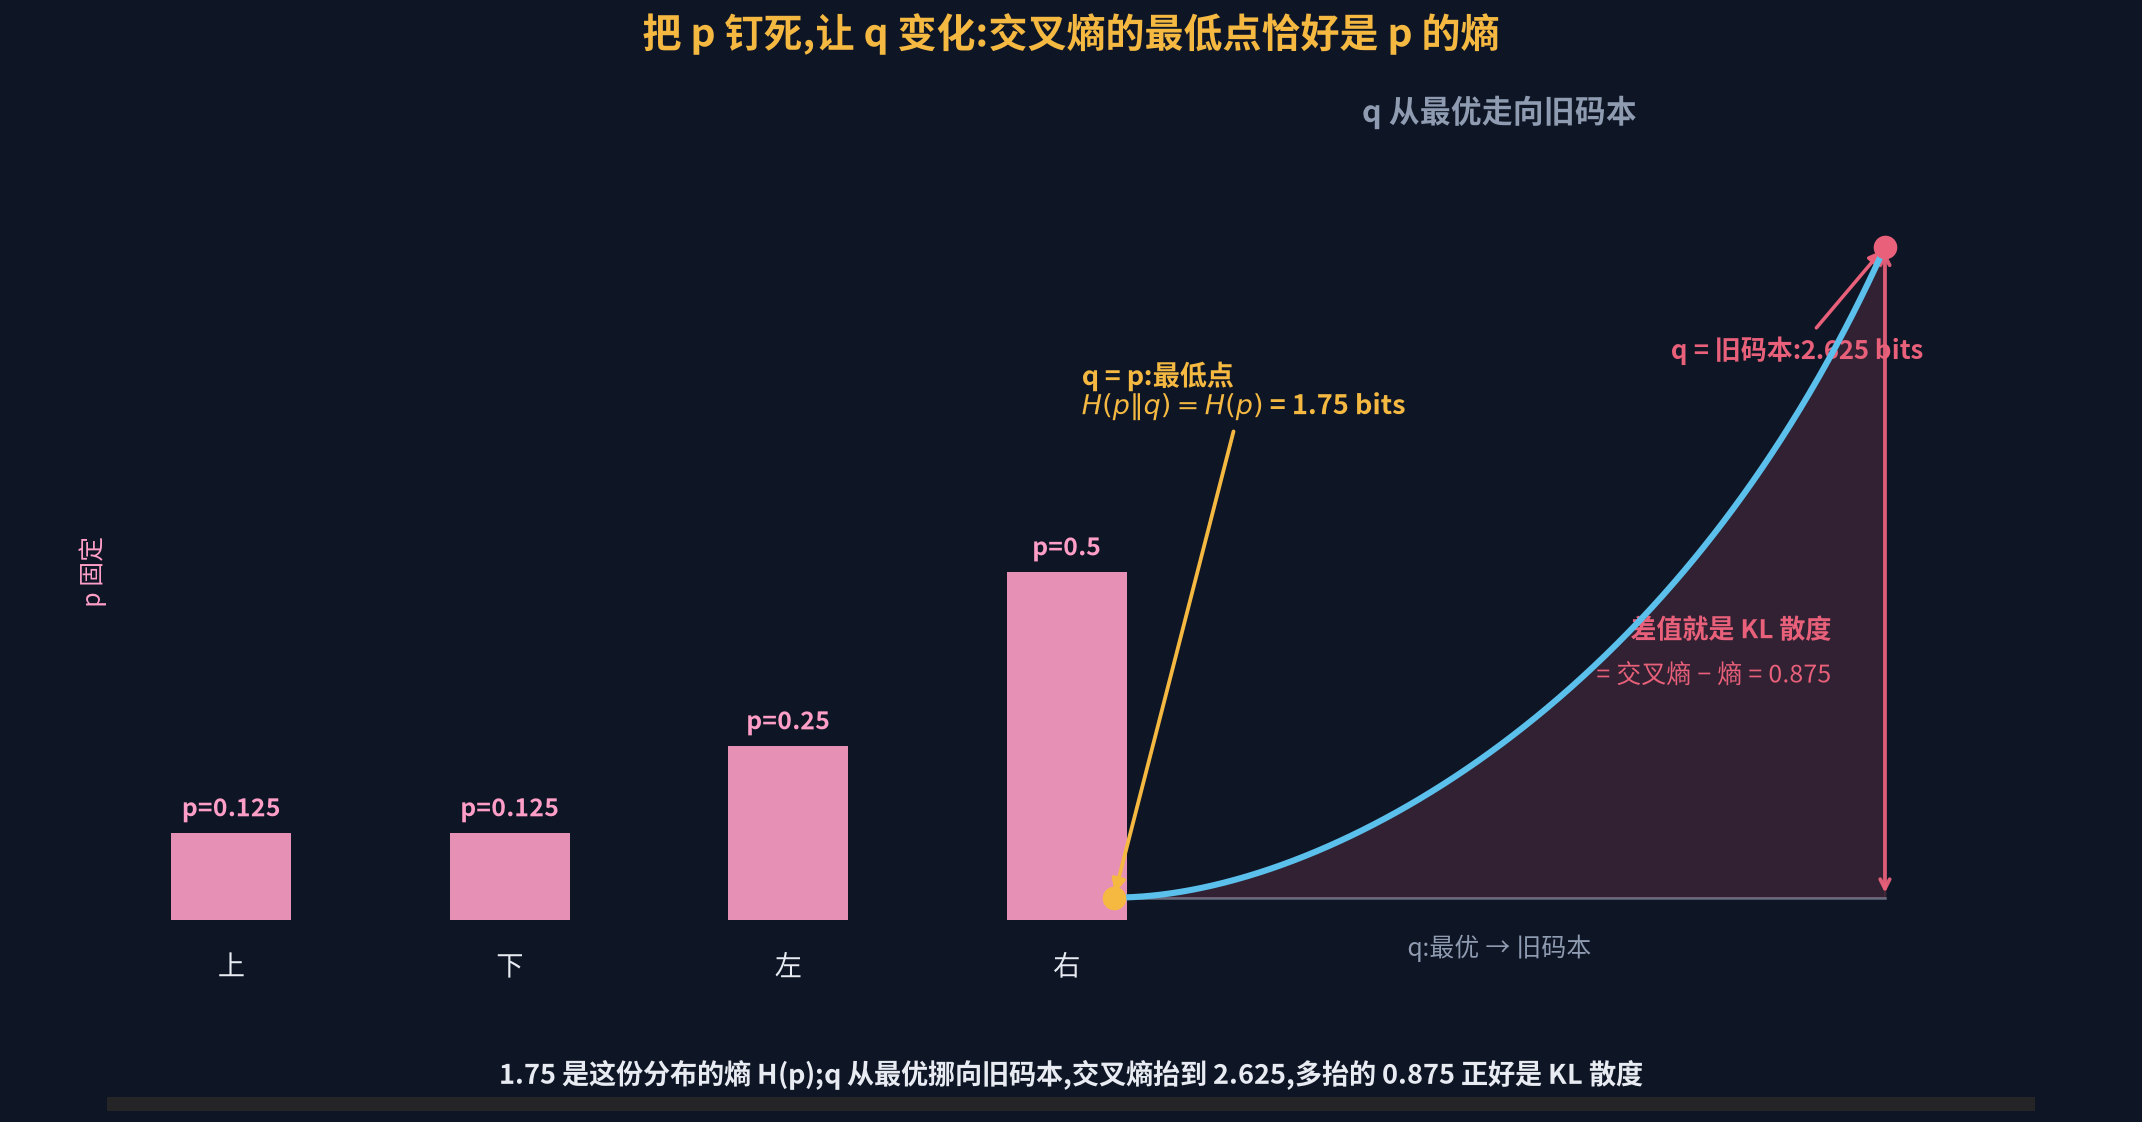
这条曲线的意义很大:熵不只是一个抽象数字,它是任何编码方案的比特数下界。q 偏离 p 一点,交叉熵就往上抬一点,抬了多少就是亏了多少。
顺带把 KL 散度定下来:
D_KL(p || q) = H(p||q) − H(p)
交叉熵减去熵,就是”用了次优编码方案,每个符号浪费的比特数”。上面的例子:2.625 − 1.75 = 0.875。机器学习中它常当分布之间的距离用——相等时为 0,差异越大越大,但不对称,不是真距离(不满足对称性)。
六、为什么公式非得是 −log
前面所有的例子都在展示交叉熵”是什么样”,这一节回答的是为什么只能是它。
语言模型的损失函数是”平均损失”。它应该满足什么性质?最自然的诉求是:只有当模型给出的分布 q 恰好等于真实分布 p 时,平均损失取最小值;其他任何 q 都更差。
那什么样的损失函数 F(q) 能做到这点?
模型对一组可能的下一个 token 给出分布 q,我们要最小化的是这个加权平均损失:
L(q) = Σ pᵢ F(qᵢ) 约束: Σ qᵢ = 1
这里有个细节容易忽略:L 是 q 的函数,但 p 是真实世界的固定事实——求导只对 q 求,pᵢ 是常数权重。这一点如果绕不过去,后面的推导就会卡住。
引入拉格朗日乘子 λ:
∂L/∂qᵢ = pᵢ F'(qᵢ) + λ = 0
对所有 i 成立,于是:
F'(qᵢ) = -λ / qᵢ (所有 i 一致,说明 F' 就是 1/q 的形式)
积分:
F(q) = -λ log q + C
再取一个边界条件把常数定下来:当只有一个是真(q = p = 1)时,预测全对,损失该是 0。代入 F(1) = -λ·0 + C = 0,所以 C = 0。
于是 F(q) = −λ log q,取 λ = 1(这只是单位选择,等价于换底数),我们得到:
F(q) = -log q
平均损失就是交叉熵,而且只有它是这个形状。
也就是说,交叉熵不是被”选出来”的,是被”逼出来”的。只要承认”平均损失应该恰好在 q=p 时最小”,−log 是唯一答案。
这里有个我读到这里才真正体会到的东西:前几节里,交叉熵是从压缩那条路自然长出来的(信息量、比特数、编码);到这一节,它又是在机器学习那条路上,用约束优化从别处被推出来的。两条完全不相关的推理链,落在同一个公式上。
七、大语言模型的损失函数
现在把前面全部拼起来。
大语言模型做的事很简单:把文本切成 token,喂进模型,让模型输出下一个 token 的概率分布 q,然后跟真实数据里的下一个 token(即 p)比。损失就是模型给真实 token 打分的对数取负,再对所有 token 求平均:
L = - (1/N) Σ log q(true token)
写成交叉熵的形式,这就是”模型分布 q 相对于真实分布 p 的交叉熵”。第 6 节证明过,这个损失恰好在模型学会数据的统计规律(q 贴近 p)时最小。
几个细节:
- 代码里几乎都用
log而不是log₂。差一个常数因子1/ln 2,会被学习率吸收,而自然对数求导干净得多。 - 预训练的终极目标,是让损失逼近语言的熵。语言的熵是下界(第 5 节那条曲线的最低点),永远到不了,但可以一直逼近。
- 形式上极其简洁,工程上极其复杂:批处理、优化器、数值稳定(softmax + log 容易出 NaN,得用
logsumexp),这些和数学无关,但都躲不开。
八、压缩即智能
回到标题。把第 7 节那句”模型视角下的平均信息量”换个说法:
模型的损失,就是它认为每个 token 值多少比特。把整个文本用这个”模型视角的比特数”加起来,就是一次压缩。
所以训练语言模型,数学上等价于训练一个最优文本压缩器。 这不是类比,是同一个目标函数的两种读法。
这条命题我现在的理解是:它在数学上严格成立——交叉熵既是压缩的期望比特数,又是预测的损失,证明路径互不相干却互相印证。但”智能”那半个词仍然是个教学框架:压缩得好不代表”懂”。Grant 真正在做的事,是把这两边放在同一个公式下面,让你自己决定这个等号要打多深。
知识蒸馏是另一个直接应用:让小模型在同一个位置,去逼近大模型给出的完整分布,损失就是小模型分布相对于大模型分布的交叉熵。好处是每个样本都能拿到整个分布的监督,而不只是一个 one-hot 标签——单个训练样本就能提供比标签多得多的信息。
九、参考资料与复现
- 原视频:But what is cross-entropy? — Compression is Intelligence Part 2(B站官方双语版)
- 系列第一篇:Reinventing Entropy — Compression is Intelligence Part 1(B站版)
- 系列播放列表:Compression is Intelligence
- 开篇实验论文:Language Trees and Zipping (Joshi et al., 2002)
正文里所有数字都可以用第三、六节的两段代码复现,纯 numpy:
- 交叉熵 2.625 bits/消息(旧码本 vs 新分布)
H(p) = 1.75bits(新分布的熵,交叉熵下界)D_KL = 0.875bits(交叉熵 − 熵)- 非对称性对照:
H(p=90/10, q=50/50) = 1.00vsH(p=50/50, q=90/10) ≈ 1.74
如果这篇笔记对你有帮助,欢迎交流。
-
Previous
交叉熵:语言模型的损失函数,为什么只能是它Cross-Entropy: The Loss Function of Language Models, and Why It Must Be This One -
Next
Readnest:我的阅读记录,为什么要搬出 NotionReadnest: Why I Moved My Reading Log Out of Notion
If this post helped you, a coffee is always welcome ☕
