最近在参加 Datawhale 的 mlsysim学习活动,任务驱动下开始系统学习 MLSysBook 的 mlsysim 仿真框架。这两天啃完了入门教程 Hello, Roofline,从”只会看显存大小选卡”到”5 行代码预测性能瓶颈”,收获不小。这篇文章既是学习总结,也把过程中踩过的概念坑和读源码发现的小细节一并整理出来。
一、Roofline 模型:四行公式看懂性能瓶颈
Roofline(屋顶线)模型来自 Williams 等人 2009 年的经典论文,是 ML 系统性能分析的地基。它的核心思想极其朴素:任何加速器都有两个天花板,你永远撞先到的那一个:
- 计算天花板(Compute ceiling):每秒能做多少次浮点运算,单位 FLOP/s。A100 的 FP16 峰值是 312 TFLOP/s。
- 存储带宽天花板(Memory ceiling):每秒能从显存搬多少数据,单位 byte/s。A100 的 HBM2e 带宽是 2.04 TB/s。
判定公式只有三行:
T_compute = FLOPs / 峰值算力
T_memory  = Bytes / 峰值带宽
T = max(T_compute, T_memory)   → 瓶颈由较大者决定
其中两个关键概念:
- 算术强度(Arithmetic Intensity, AI)= FLOPs ÷ Bytes:每搬 1 字节数据能做几次浮点运算。AI 高说明工作负载”计算密集”,AI 低说明它”数据密集”。
- 脊点(Ridge Point)= 峰值算力 ÷ 峰值带宽:AI 与脊点的位置关系直接决定瓶颈类型。
判定规则很简单:AI < 脊点 → Memory-Bound(GPU 饿着肚子等数据,加算力没用);AI > 脊点 → Compute-Bound(带宽喂得饱,瓶颈在算力本身)。
一个方便记忆的比喻:把 GPU 想成厨师,显存带宽是传菜窗口。算术强度是”取一次食材能切几刀”。切一刀就要等一次菜 → 内存受限;取一次菜能切几十刀 → 算力受限。
⚠️ 两个容易踩的坑(教程里专门强调了):
- FLOP 计数惯例:行业惯例 1 次乘加(MAC)= 2 FLOPs,而 MLSys Zoo 统一按 1 MAC = 1 FLOP 计。这会让 ALL 数值差一倍——A100 的脊点,2-FLOP 口径下是 ~312 FLOP/byte,1-FLOP 口径下是 ~156。对比任何论文、任何工具的数字之前,先确认对方用的哪种口径。
- Roofline 是上界,不是预测值:真实性能因为调度开销、访存模式、利用率不足,通常只有屋顶的 40%–60%。它的价值不是精确报延迟,而是告诉你哪一个资源在约束你。
二、MLSys·im 上手:5 步跑通
mlsysim 的价值在于:不需要真 GPU、不需要装框架、不写一行 CUDA,30 秒内在笔记本上就能完成”模型 × 硬件”的性能预测。用到的核心 API 就两条:
import mlsysim
from mlsysim import Engine

# 1. 从 Zoo 里取"经过审核"的模型和硬件规格,不用翻 datasheet
model = mlsysim.Models.Vision.ResNet50        # 25.6M 参数,4.1 GFLOP/推理
hardware = mlsysim.Hardware.Cloud.A100        # 312 TFLOP/s,2.04 TB/s

# 2. 一行 solve:模型 + 硬件 + 配置 → 瓶颈、延迟、吞吐
profile = Engine.solve(model=model, hardware=hardware, batch_size=1, precision="fp16")
print(profile.bottleneck, profile.latency, profile.throughput)
# → Memory  0.543 ms  1843 images/s

# 3. 扫描 batch size,观察瓶颈翻转;plot_roofline 一键可视化
全程不需要任何真实硬件——这恰恰是它的教学价值:用一阶模型先把直觉建立起来,再上真机验证。
三、实验与结果
3.1 ResNet-50 × A100:Batch 扫描与瓶颈翻转
实验配置:ResNet-50(25.6M 参数 = 51.2 MB FP16,4.1 GFLOP/推理),A100,FP16。Engine.solve 的默认计算效率 efficiency=0.5,因此有效脊点 = 312 × 0.5 ÷ 2.039 ≈ 76.5 FLOP/byte(理论脊点 312 ÷ 2.039 ≈ 153)。
| Batch | 延迟 (ms) | 吞吐 (img/s) | 瓶颈 |
|---|---|---|---|
| 1 | 0.543 | 1,843 | Memory |
| 2 | 0.568 | 3,524 | Compute |
| 4 | 0.620 | 6,450 | Compute |
| 8 | 0.725 | 11,031 | Compute |
| 16 | 0.936 | 17,103 | Compute |
| 32 | 1.356 | 23,598 | Compute |
| 64 | 2.197 | 29,130 | Compute |
| 128 | 3.879 | 32,997 | Compute |
| 256 | 7.243 | 35,343 | Compute |
几个关键发现:
- 交叉点(Crossover)在 batch=2:AI 从 batch=1 的 72.8 跳到 batch=2 的 133.5,一举越过有效脊点 76.5。原因很直观——增大 batch 时 FLOPs 严格翻倍,但模型权重只从显存加载一次,访存量几乎不变,AI 自然暴涨。
- 吞吐量增长 19.2 倍但边际收益急剧递减:batch 1→2 增长 +91%,2→4 增长 +83%,32→64 只剩 +23%,128→256 仅 +7%。越过脊点后,瓶颈切换到算力,吞吐逐渐逼近硬件的算力上限。
- MFU 视角:batch=1 时这批 A100 的算力利用率(MFU)只有 2.4%,batch=256 时才到 46.4%(引擎自带
mfu字段)。这就是教程里那句 “most of the A100’s 312 TFLOP/s is idle” 的量化证据。
3.2 A100 vs H100:更强的卡,不自动兑现红利
H100 的规格:A100 的 3.2 倍算力(989 TFLOP/s),但只有 1.64 倍带宽(3.35 TB/s)。算力和带宽的增长幅度不对称,脊点被顶得更高:有效脊点 = 989 × 0.5 ÷ 3.35 ≈ 147.6。
对比结果:
| Batch | A100 瓶颈 | H100 瓶颈 | H100 吞吐 (img/s) |
|---|---|---|---|
| 1 | Memory | Memory | 1,898 |
| 2 | Compute | Memory | 3,785 |
| 4 | Compute | Compute | 7,364 |
| 32 | Compute | Compute | 41,273 |
| 128 | Compute | Compute | 81,463 |
两个非常反直觉的结论:
- batch=1 时,H100 比 A100 只快 3%(1898 vs 1843 img/s)。因为两者都内存受限,比拼的是带宽:3.35 vs 2.04 TB/s ≈ 1.64×,但零散的延迟开销把差距稀释了。多花数倍的卡钱,换不来对应的加速。
- H100 的交叉点更晚(batch=4 vs batch=2)。脊点越高,需要越大的 batch 才能”喂饱”算力。直到 batch=128,H100 才拉开 2.47 倍的优势——此时两者都深度计算受限。
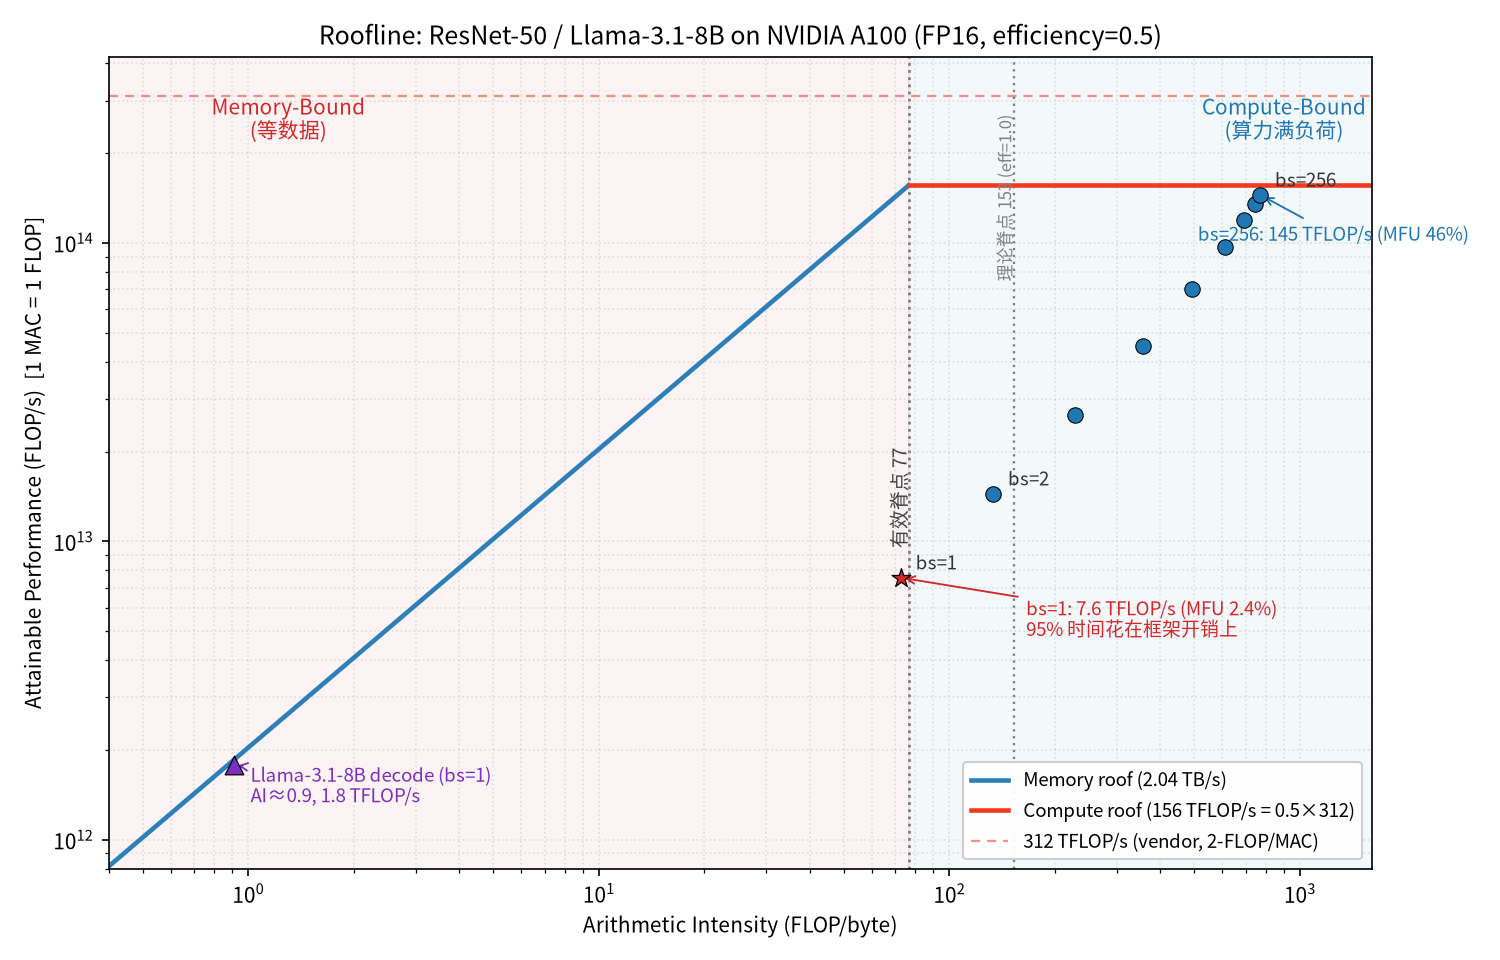
图 1:工作负载的算术强度与硬件脊点的对比。蓝色区域为计算受限区,红色为内存受限区。注意 batch=1 的 ResNet-50 实际工作点(7.6 TFLOP/s)远远低于内存屋顶(148 TFLOP/s)——这正是固定开销存在的证据,下文会展开。
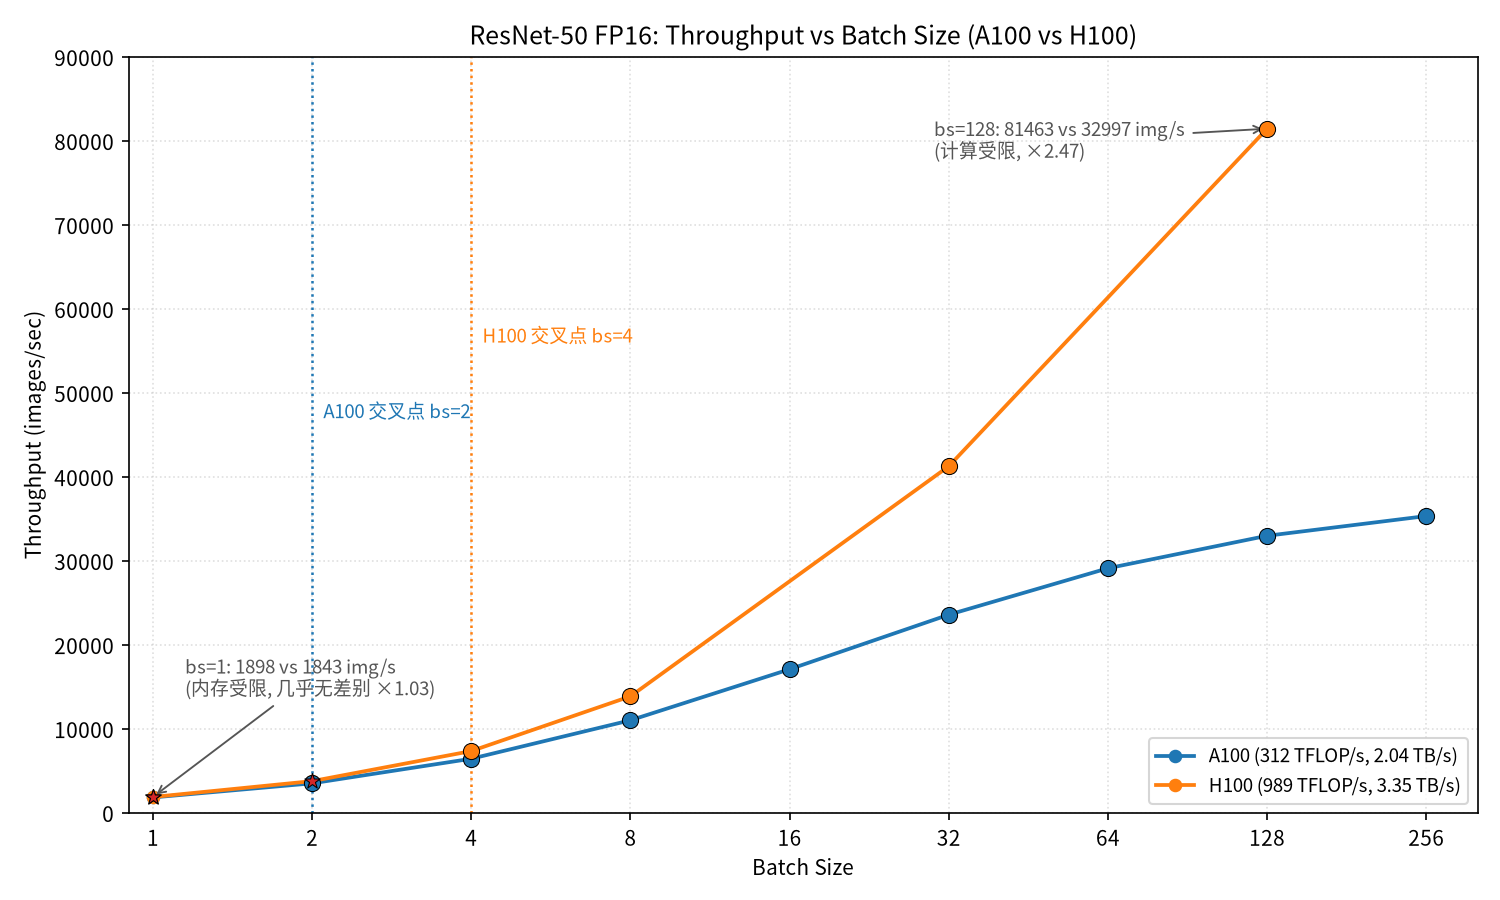
图 2:两个硬件的吞吐量随 batch 的变化。小 batch 时几乎重合(都是内存受限),大 batch 时差距拉到 2.5 倍。
3.3 Llama-3.1-8B:典型的”内存墙”负载
最后把模型换成 Llama-3.1-8B(8.03B 参数 = 16.06 GB,单 token 16.06 GFLOP),A100 上 batch=1:
- 算术强度 AI ≈ 0.91 FLOP/byte(权重复用率约等于 1:每读一个 2 字节的权重,只做 2 次浮点运算),远低于任何硬件的脊点。
- 延迟 9.0 ms,吞吐 111 tok/s,Memory-Bound。
- 拆解看:T_memory = 8.66 ms 对 T_compute = 0.10 ms,带宽瓶颈碾压性地主导。
LLM 解码是自回归的,一次只生成一个 token,却要把整个模型权重(以及 KV-Cache)从 HBM 过一遍。AI 只有 1 的量级,意味着它天生就站在屋顶最陡峭的斜坡最底部。这也是为什么 LLM 推理的优化方向从来不是”堆算力”,而是减少数据搬运:量化(GPTQ/AWQ)、KV Cache 优化、算子融合、PagedAttention……
四、学习过程中的疑惑与解答
学习过程中我向 AI 助教提了一连串问题,这里挑几个有代表性的复盘(都是第一次接触时真实卡住的地方):
Q1:教程里的 HBM 是什么?”memory bottleneck” 指的是计算机内存吗?
HBM(High Bandwidth Memory)就是 GPU 的显存,只是它不是普通 GDDR,而是 3D 堆叠 + 硅通孔(TSV)工艺的高速 DRAM。A100 用 HBM2e(2.04 TB/s),H100 用 HBM3(3.35 TB/s)。Roofline 里的 “Memory” 天花板由显存带宽决定,与 CPU 侧的系统内存(RAM)无关——GPU 推理时数据搬运基本不经过系统内存。当初我把 “memory-bound” 理解成”电脑内存不够”,方向完全错了。
Q2:1 MAC = 1 FLOP 还是 2 FLOP?一个约定为什么值得单独写一段?
因为它会让所有结论差一倍。NVIDIA 官方把一次乘加算 2 FLOPs,所以 A100 标称 312 TFLOP/s;MLSys Zoo 按 1 FLOP 计,ResNet-50 的 4.1 GFLOP 就是这个口径。如果混用两种口径去算脊点,会得到 156 和 312 两个差一倍的数字。先对齐口径,再比较数字——这句话在性能分析里怎么强调都不过分。
Q3:教程说 batch=1 时”两个天花板 nearly balanced”,又说”大部分算力闲置”,这不矛盾吗?
不矛盾,但确实绕。batch=1 时 AI≈72.8(或教程按四舍五入的 82),和脊点 156 在数量级上接近——接近”形象地说”是平衡;但 72.8 < 156,依然在内存受限的斜坡上,算力确实闲着。实测 MFU 只有 2.4%,这就叫”nearly balanced but memory-bound”:离及格线近,不等于及格了。要把闲置的算力用起来,唯二的路:加大 batch(把 AI 推过脊点),或者减小数据搬运。
Q4:为什么 batch 从 1 改到 2,瓶颈立刻就从 Memory 翻成 Compute?
回到 AI 的定义:分子 FLOPs 按 batch 线性翻倍,分母 Bytes 却几乎不动(权重只加载一次,激活值只占权重的一小部分)。所以 AI 从 72.8 直接跳到 133.5,一举越过有效脊点 76.5。batch size 是调节算术强度最直接的旋钮,这是本次实验最大的手感收获。
Q5:教程手算的延迟是 0.026 ms,为什么 Engine.solve 报 0.543 ms?
这是我读引擎源码才彻底搞懂的问题,见下一节——也是我觉得最有”技术含量”的一个发现。
五、读源码挖出的两个细节
细节一:引擎的延迟公式 = max(计算, 访存) + 固定开销
打开 mlsysim/core/engine.py,单节点推理的延迟公式是这样的:
latency = max(T_compute, T_memory) + dispatch_tax + num_layers × 10μs(层税)
ResNet-50 有 50 层,每层 10μs 的框架税 + 0.02ms 调度开销,固定部分高达 0.515 ms——而 batch=1 时纯计算/访存时间只有 0.026/0.028 ms。也就是说,延迟的 95% 是”框架税”。这完美解释了教程里那句低调的 “Engine.solve 报告的延迟可能与手算略有不同”:
- 教程手算的 0.026 ms 是纯粹的上界(理想流水线);
- 引擎的 0.543 ms 是”上界 + 每层软件开销”的工程现实。
这也让 Roofline 的”上界”性质变得非常具体:小 batch 下,固定开销把实际性能死死压在屋顶下方,图 1 里 batch=1 的点离内存屋顶的巨大落差就是它。真实系统里,算子太小、调用太频繁时,框架开销会反客为主——这其实就是教程后面 “Two Phases, One Request” 和框架开销墙(Wall 7)的伏笔。
细节二:引擎默认 efficiency=0.5,脊点要折半看
Engine.solve 有个不起眼的默认参数 efficiency: float = 0.5,有效算力 = 峰值 × 效率。这意味着:
- 教程纸面上的判定线是 156 FLOP/byte(按 1-FLOP 口径的峰值 312 ÷ 2.0 TB/s);
- 引擎实际判定用的有效脊点是 76.5 FLOP/byte(312 × 0.5 ÷ 2.039)。
所以教程说 “batch=1 的标签取决于精确假设”,而引擎直接输出 “Memory”——因为引擎的默认假设(efficiency=0.5)把脊点拉低了一半。用仿真工具时,默认参数也是模型的一部分,不看源码你根本不知道它替你做了哪些假设。
六、个人思考
-
先判 regime,再谈优化。Roofline 教我的第一件事:拿到一个陌生模型,先算 AI = FLOPs ÷ Bytes,和硬件脊点比一比,再决定优化方向。Memory-Bound 就去做量化/融合/减搬运,Compute-Bound 才去堆算力和调精度。方向错了,再精细的优化都是在错误的一侧努力。
-
batch size 是性价比最高的旋钮,但有天花板。小 batch 翻倍 batch,吞吐量接近翻倍;可越过脊点之后收益迅速衰减(+91% → +7%)。在线推理场景还要受延迟约束(batch 越大单请求延迟越高,0.54 → 7.24 ms),所以实际部署是在吞吐与延迟之间找平衡点。
-
“升级硬件”不是一个简单命题。H100 算力是 A100 的 3.2 倍,但在内存受限的工作负载上只快 3%。选卡之前,先回答一个问题:我的工作负载在屋顶的哪一侧? 顺便说一句,一个有趣的反例:边缘设备(如 Jetson AGX Orin)算力和带宽都低,但算力/带宽比反而最高,脊点最高——意味着小模型在边缘设备上更容易”怎么喂都喂不饱算力”。
-
LLM 推理是内存墙的奴隶。AI ≈ 1 FLOP/byte 意味着:除非改变数据搬运的本质(量化、缓存、稀疏化),否则堆算力对单流延迟几乎无效。这也解释了为什么推理框架的军备竞赛在 KV Cache 和量化上,而不是在 SM 数量上。
-
一阶分析工具值得多用。mlsysim 这类仿真把”机理解释力”和”计算速度”都拉满了——它不追求精度,追求的是让你在动手前就建立正确的直觉。读源码的过程中我还发现它有完整的训练侧模型(3D 并行、通信开销、Pipeline bubble),下一步可以继续深入。
七、下一步与参考资料
- 教程链:Hello, Roofline(本篇) → 01 The Memory Wall(为什么 3.2× 算力换不来 3.2× 加速) → 02 Two Phases, One Request(prefill 计算受限 vs decode 内存受限)。
- 打卡任务:Datawhale llm-algo-leetcode #76
- 复现方法:
pip install mlsysim,然后:
import mlsysim
from mlsysim import Engine
model = mlsysim.Models.Vision.ResNet50
hardware = mlsysim.Hardware.Cloud.A100
for bs in [1, 2, 4, 8, 16, 32, 64, 128, 256]:
    p = Engine.solve(model=model, hardware=hardware, batch_size=bs, precision="fp16")
    print(bs, p.bottleneck, f"{p.throughput:.0f}/s")
- 环境:WSL2 + conda 环境 mlsysim(python 3.11,mlsysim 0.1.1),全程无 GPU。
附:完整运行脚本(可直接复制运行)
"""
MLSys·im Task 1: Roofline 模型实战 - ResNet50 on A100
对应打卡要求:https://github.com/datawhalechina/llm-algo-leetcode/issues/76
教程参考:https://mlsysbook.ai/mlsysim/tutorials/00_hello_roofline.html
"""

import mlsysim
from mlsysim import Engine

print(f"✅ mlsysim version: {mlsysim.__version__}")

# ================= 1. Setup: 选择模型与硬件 =================
# 严格按照教程 API 调用内置模型和硬件
model = mlsysim.Models.Vision.ResNet50
hardware = mlsysim.Hardware.Cloud.A100

print(f"\n📦 Model: {model.name}")
print(f"   - Parameters: {model.parameters:,}")
print(f"   - Inference FLOPs (single image): {model.inference_flops:,}")

print(f"\n🖥️  Hardware: {hardware.name}")
print(f"   - Peak Compute (FP16): {hardware.compute.peak_flops.to('TFLOPs/s')}")
print(f"   - Memory Bandwidth: {hardware.memory.bandwidth.to('TB/s')}")

# ================= 2. 最小实验: Single Image Inference =================
print("\n" + "="*60)
print("🔍 Single Image Inference (batch_size=1)")
print("="*60)

profile = Engine.solve(
    model=model,
    hardware=hardware,
    batch_size=1,
    precision="fp16"
)

print(f"   - Latency: {profile.latency.to('ms')}")
print(f"   - Throughput: {profile.throughput}")
print(f"   - Bottleneck: {profile.bottleneck}")

# ================= 3. Batch Size 扫描 =================
print("\n" + "="*60)
print("📊 Batch Size Sweep (1 → 256)")
print("="*60)
print(f"{'Batch':<8} {'Latency(ms)':<14} {'Throughput':<18} {'Bottleneck'}")
print("-" * 60)

batch_sizes = [1, 2, 4, 8, 16, 32, 64, 128, 256]
results = []

for bs in batch_sizes:
    p = Engine.solve(model=model, hardware=hardware, batch_size=bs, precision="fp16")
    results.append(p)
    print(f"{bs:<8} {p.latency.to('ms'):<14} {str(p.throughput):<18} {p.bottleneck}")

# ================= 4. Exercise 2: A100 vs H100 对比 =================
print("\n" + "="*60)
print("✏️  Exercise 2: A100 vs H100 Crossover Comparison")
print("="*60)

h100 = mlsysim.Hardware.Cloud.H100
print(f"H100 Peak Compute (FP16): {h100.compute.peak_flops.to('TFLOPs/s')}")
print(f"H100 Memory Bandwidth: {h100.memory.bandwidth.to('TB/s')}")

print(f"\n{'Batch':<8} {'A100 BN':<15} {'H100 BN'}")
print("-" * 40)

for bs in [1, 8, 32, 64, 128]:
    pa = Engine.solve(model=model, hardware=hardware, batch_size=bs, precision="fp16")
    ph = Engine.solve(model=model, hardware=h100, batch_size=bs, precision="fp16")
    print(f"{bs:<8} {pa.bottleneck:<15} {ph.bottleneck}")

# ================= 5. Exercise 3: Llama-3 8B 分析 =================
print("\n" + "="*60)
print("✏️  Exercise 3: Llama-3-8B Memory-Bound Analysis")
print("="*60)

llama = mlsysim.Models.Language.Llama3_8B
p_llama = Engine.solve(model=llama, hardware=hardware, batch_size=1, precision="fp16")

print(f"Model: {llama.name}")
print(f"   - Parameters: {llama.parameters:,}")
print(f"   - Batch=1 Latency: {p_llama.latency.to('ms')}")
print(f"   - Bottleneck: {p_llama.bottleneck}")
print(f"\n💡 Why Memory-Bound?")
print(f"   LLM autoregressive decoding processes ONE token at a time.")
print(f"   FLOPs are tiny (only attention + FFN for 1 token),")
print(f"   but must load ENTIRE KV-Cache + weights from HBM.")
print(f"   → Very low arithmetic intensity → Memory-Bound")
如果这篇笔记对你有帮助,欢迎交流。
-
Previous
个人主页升级实战:Jekyll 增量改造的取舍与落地Upgrading My Personal Site: Jekyll Incremental Refactoring — Trade-offs and What Actually Shipped -
Next
用 5 行代码预测模型瓶颈:MLSys·im Roofline 教程学习笔记Predicting Model Bottlenecks in 5 Lines of Code: MLSys·im Roofline Tutorial Notes
If this post helped you, a coffee is always welcome ☕
