上一篇 内存墙与两阶段 把一次 LLM 请求拆成了两堵墙:Prefill 撞算力墙、Decode 撞内存墙。今天进入 Datawhale mlsysim 学习活动的第三阶段,把视角从”时间”转向”空间”:显存到底去哪了?模型变大了怎么办? 对应教程 KV-Cache: The Hidden Memory Consumer 和 Quantization: Not a Free Lunch。今天的核心工具从
Engine换成ServingModel、calc_kv_cache_size和CompressionModel,三个工具正好对应三个问题:请求占多少显存、一张卡能塞多少请求、权重变小到底加速什么。
一、KV-Cache:显存去哪了
Task 2 结束时我们留下一个伏笔:70B 模型 FP16 权重 141.2 GB,远超单张 H100 的 85.9 GB(80 GiB)。那”显存去哪了”这个问题,先从权重账算起(E1):
| 模型 | FP16 | INT8 | INT4 |
|---|---|---|---|
| Llama-3-8B | 16.06 GB | 8.03 GB | 4.02 GB |
| Llama-3-70B | 141.2 GB | 70.6 GB | 35.3 GB |
8B 参数 × 2 字节 = 16.06 GB;70B × 2 字节 = 141.2 GB。70B 在 FP16 下单卡放不下,INT8(70.6 GB)勉强、INT4(35.3 GB)才从容——这是第一个结论,但更关键的问题在后面:就算把权重塞进显存,一个 2K 请求的 KV-Cache 吃多少?
KV-Cache 是 Decode 阶段复用历史 token 的 K/V 矩阵而缓存下来的显存块。它的公式长这样:
KV-Cache = 2 × L × n_kv_heads × head_dim × seq_len × batch_size × bytes_per_elem
每一项都能在 Llama-3-8B 的超参数里找到对应:
| 符号 | 含义 | Llama-3-8B 的值 |
|---|---|---|
| L | 层数 | 32 |
| n_kv_heads | KV 头数(GQA 下远小于 Q 头) | 8 |
| head_dim | 每头维度 | 128 |
| seq_len | 序列长度 | 可变 |
| batch_size | 并发请求数 | 可变 |
| bytes_per_elem | 每元素字节 | FP16=2, INT8=1, INT4=0.5 |
代进公式验算一遍单请求 2K 上下文:
2 × 32 × 8 × 128 × 2048 × 1 × 2 = 268,435,456 bytes = 0.268 GB
和 ServingModel.solve() 输出的 kv_cache_size 一字不差:0.268 GB。公式手算、引擎输出、以及 官方博客 的数值三方对上了。把序列长度拉长,E2 的账本长这样:
| 序列长度 | 单请求 KV-Cache (8B) | 相对 4K 的倍数 |
|---|---|---|
| 2K (2048) | 268 MB | 0.5× |
| 4K (4096) | 537 MB | 1× (基准) |
| 32K (32768) | 4,295 MB | 8× |
| 128K (131072) | 17,180 MB | 32× |
KV-Cache 与序列长度严格线性:长度翻倍,缓存精确翻倍。 因为公式里 seq_len 是简单相乘项,没有任何摊销。128K 的单请求 KV-Cache(17.18 GB)已经比模型权重(16.06 GB)还大——长上下文不是免费的,它按 token 计价。
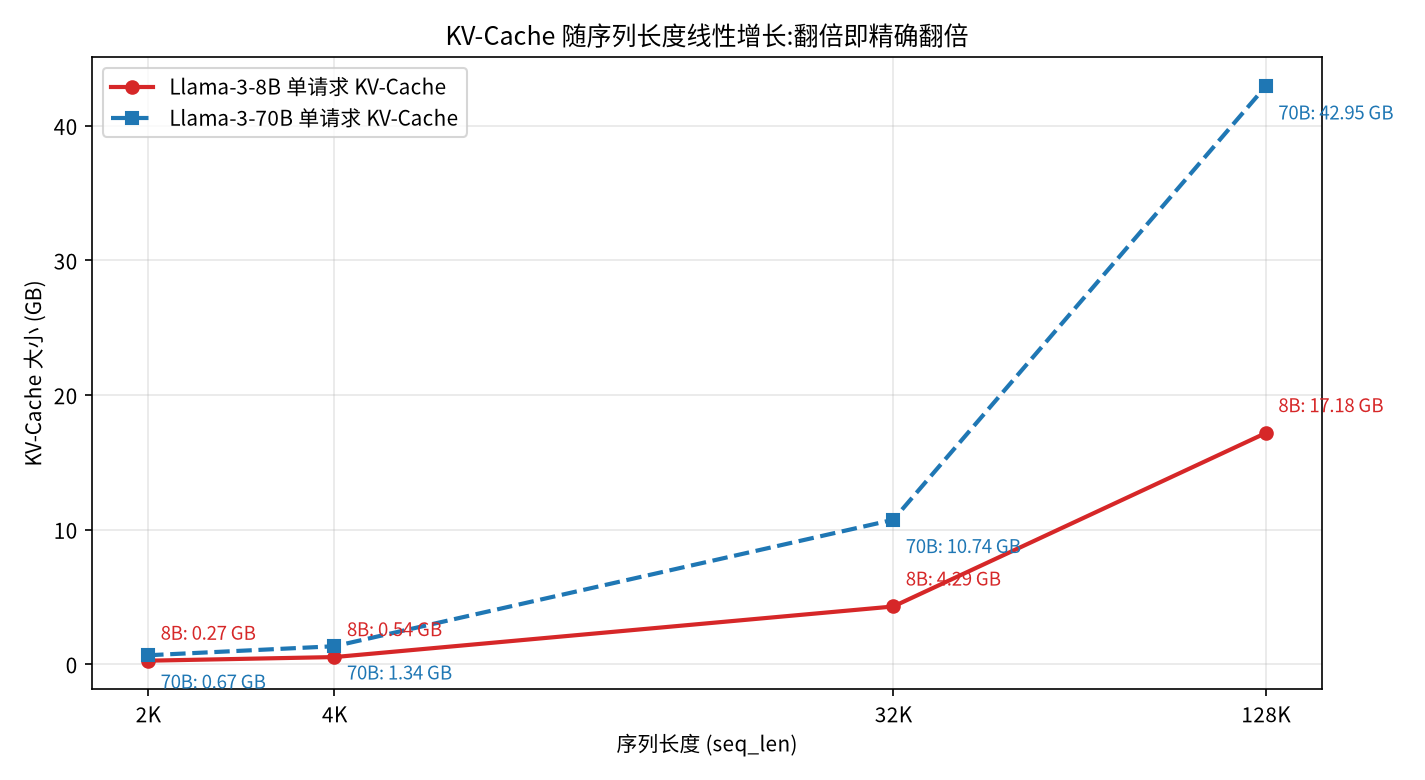
图 1:KV-Cache 随序列长度线性增长,8B 与 70B 都是严格的直线(70B 层数是 8B 的 2.5 倍,斜率相应更高)。
二、容量墙:序列长度决定并发上限
权重 16.06 GB 放进 85.9 GB 的 H100,剩下的钱买 KV-Cache。于是 E3 的核心问题浮出水面:给定序列长度,一张卡最多能同时服务多少个请求?
最朴素的算法:最大并发 = (85.9 − 16.06) ÷ 单请求 KV-Cache。4K 时:69.84 ÷ 0.537 ≈ 130。再用 ServingModel.solve() 的 feasible 属性扫一遍,四种序列长度的真值:
| 序列长度 | 单请求 KV-Cache | 最大并发请求 (feasible) | 规律 |
|---|---|---|---|
| 2K | 268 MB | 260 | 基准 |
| 4K | 537 MB | 130 | 减半 |
| 32K | 4,295 MB | 16 | 再减半×4 |
| 128K | 17,180 MB | 4 | 只剩个位数 |
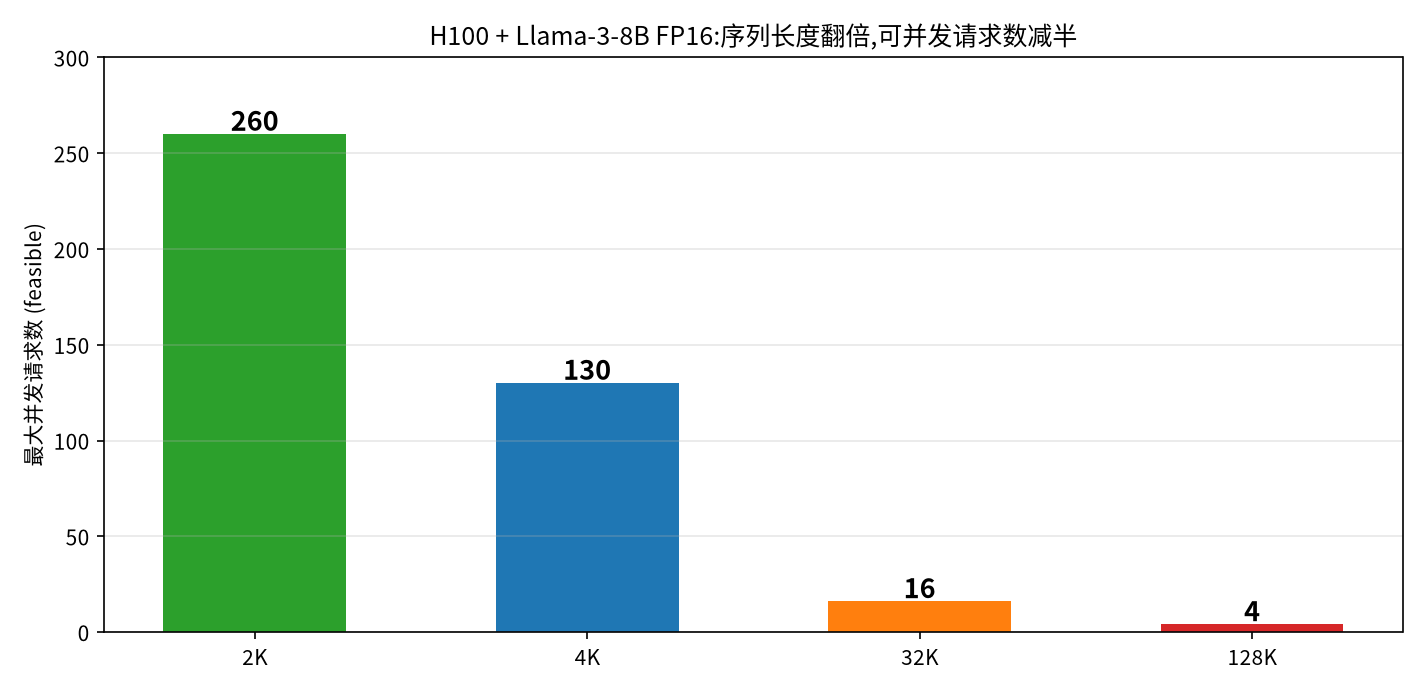
图 2:序列长度翻倍 → 并发上限减半,这是 KV-Cache 纯线性增长的直接后果。
这个 130 的数字和手算完全吻合,也说明 ServingModel 的显存预算是”权重 + KV-Cache + 系统开销”的简单加法。注意 128K 上下文时并发只剩 4——即便单请求 128K 是 feasible 的(总占用 33.24 GB),并发容量也已经趋近于零。相比 2K 的 260 并发,128K 的性价比是断崖式的。
这就是”容量墙”(第二篇提过内存墙的第二种形态):带宽墙决定每个 token 多快,容量墙决定一张卡能服务多大的模型、多少个并发。 序列长度是按下并发上限的那个旋钮。
三、模型变大怎么办:8B → 70B 与量化
O1:模型规模放大,两阶段同步放大
从 8B 换到 70B(FP16,H100,seq 2048,bs 1),实测:
| 指标 | Llama-3-8B | Llama-3-70B | 放大倍数 |
|---|---|---|---|
| 权重 | 16.06 GB | 141.2 GB | 8.8× |
| TTFT (Prefill) | 70.97 ms | 607.0 ms | 8.6× |
| ITL (Decode) | 5.19 ms | 43.15 ms | 8.3× |
参数量放大 8.8 倍,TTFT 和 ITL 同步放大 8 倍多——两个阶段都被模型规模线性主导。TTFT 因为 prefill 的 FLOPs 正比于参数量;ITL 因为 decode 每 token 要把全部权重搬一遍,权重翻 8.8 倍,搬运时间就翻 8.8 倍。这印证了 Task 2 的结论:瓶颈阶段不因模型变大而改变,只是两堵墙都变高了。
E4+E5:量化对 Decode 有效,对 Prefill 无效
量化把权重字节数减半/减到 1/4,对两个阶段的影响完全不对称(8B,H100,seq 2048):
| 精度 | 权重 | ITL (Decode) | TTFT (Prefill) |
|---|---|---|---|
| fp16 | 16.06 GB | 5.19 ms | 70.97 ms |
| int8 | 8.03 GB | 2.76 ms (1.9×) | 35.47 ms (2.0×) |
| int4 | 4.02 GB | 1.54 ms (3.4×) | 70.97 ms (1.0×) |
- Decode 侧:字节减半,ITL 减半。 5.19 → 2.76 → 1.54,单调地随权重大小走。decode 是”每 token 全量搬权重”,字节数就是命门。
- Prefill 侧:只有硬件有低精度算力路径才加速。 int8 时 H100 有 1979 TFLOP/s 的 INT8 算力表项,TTFT 减半;int4 时 H100 没有原生 INT4 稠密加速路径,查表回退 FP16 峰值,TTFT 打回原形——这个”倒 V”在第二篇已经挖到底了。
一句话:量化救 Decode,不救 Prefill。
四、压缩与剪枝:省存储 ≠ 省时间
Task 3 的选做实验 O3 用 CompressionModel 对比量化和剪枝两条压缩路线。我把它俩完整跑了一遍(8B, H100):
| 方法 | 压缩后体积 | 压缩比 | 精度损失 | 推理加速 | 存储节省 |
|---|---|---|---|---|---|
| FP16 (baseline) | 16.06 GB | 2.0× | +0.00% | 2.00× | 50.0% |
| INT8 量化 | 8.03 GB | 4.0× | -0.00% | 4.00× | 75.0% |
| INT4 量化 | 4.02 GB | 8.0× | -0.03% | 8.00× | 87.5% |
| 剪枝 50% (非结构化) | 16.06 GB | 2.0× | -0.00% | 1.00× | 50.0% |
| 剪枝 75% (非结构化) | 8.03 GB | 4.0× | -0.04% | 1.00× | 75.0% |
| 剪枝 90% (非结构化) | 3.21 GB | 10.0× | -0.06% | 1.00× | 90.0% |
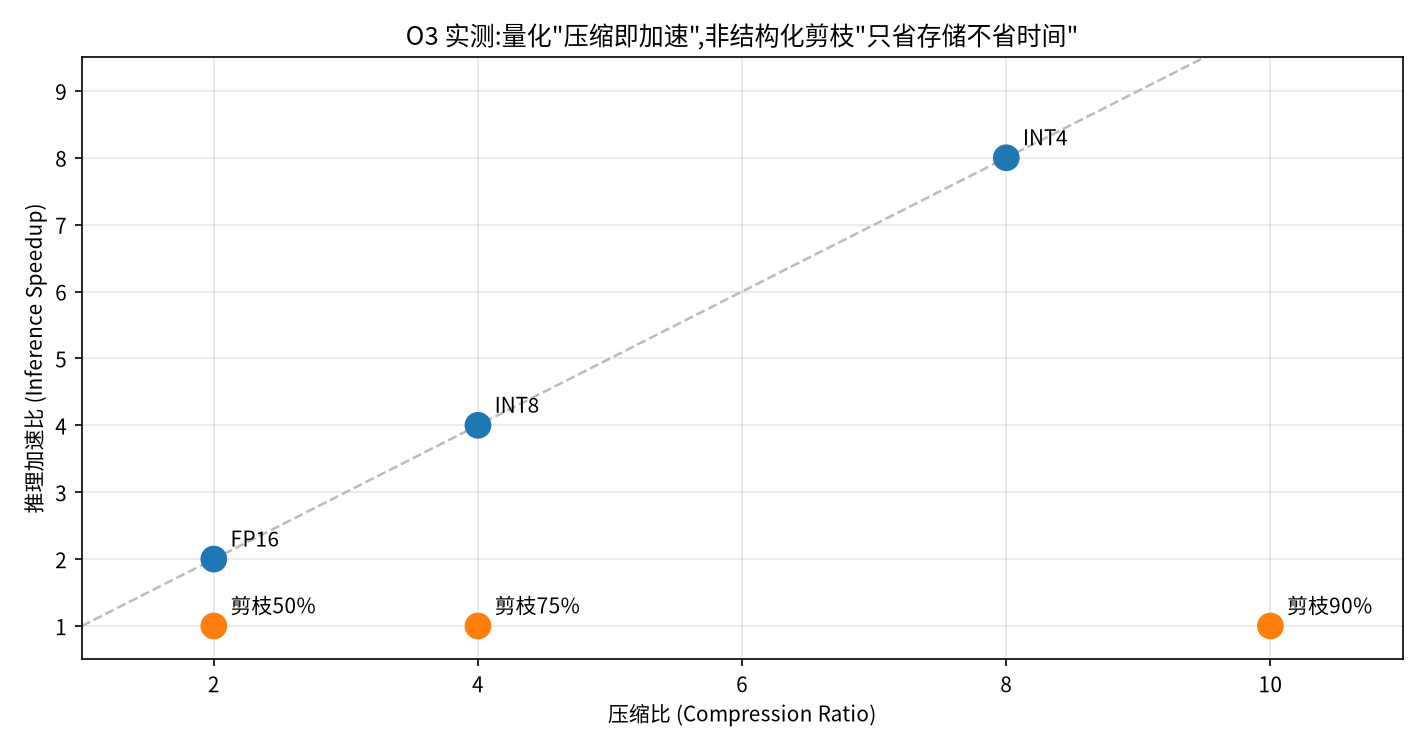
图 3:量化紧贴”压缩多少倍就快多少倍”的理想线;非结构化剪枝压缩再多倍,推理加速恒为 1.00×——省了存储,没省时间。
两个一眼可见的规律:
- 量化:压缩比 = 加速比。 INT4 压缩 8 倍、加速 8 倍。因为量化直接减少每个权重元素的位宽,decode 阶段搬运的字节数成比例减少,
inference_speedup忠实反映”少搬了多少”。 - 非结构化剪枝:压缩比很大,加速恒 1.00×。 剪枝 90% 省了 90% 存储,但推理一步都没快。这是最反直觉、也最有教学价值的一行——省存储和省时间在非结构化剪枝上是完全脱钩的。
为什么非结构化剪枝不加速?
这是今天问出的核心问题。原因在硬件和稀疏模式的双重不匹配:
- GPU 是为稠密 GEMM 设计的。 神经网络推理的核心是矩阵乘法,GPU 的 Tensor Core 假设矩阵每个位置都有有效数值,以 tile 为单位全速吞吐。硬件层面没有”如果值是零就跳过”的逻辑。
- 非结构化剪枝产生的是”随机稀疏”。 逐元素把绝对值最小的权重置零,零值随机散布在矩阵里。这种模式既不符合 GPU 的稠密计算范式,也不是硬件能识别的规则稀疏。
- “存得下”和”算得快”是两道工序。 剪枝后可以用压缩格式只存非零值,模型文件确实变小了;但计算时要么解压成稠密矩阵再算(没加速),要么做稀疏 GEMM——随机稀疏的稀疏矩阵乘法加速比接近 0,还要额外付索引开销。
- 硬件加速稀疏要的是”规则稀疏”。 NVIDIA Ampere 及以后的稀疏 Tensor Core 支持 2:4 模式(每 4 个元素恰好 2 个零),可以加速 2 倍,但要求剪枝算法刻意满足这个模式。普通非结构化剪枝(随机零分布)达不到。
对照图 3 就很清楚了:量化是”让每个数变短”,直接减少搬运量;非结构化剪枝是”抹掉一些数”,减少的是存储,不是一次要搬的字节数——因为稀疏矩阵在普通硬件上依然按稠密格式参与计算。这也是工业界量化比非结构化剪枝普及得多的根本原因。
(一个澄清:引擎里 estimated_accuracy_delta 是简化的静态估算,本地数值(-0.03% ~ -0.06%)比一些教程给的”INT4 损失 2.5%”温和得多,它只用于展示权衡方向,不是真实评估——见第六节。)
五、学习过程中的疑惑与解答
Q1:PagedAttention 是显卡机制还是模型机制?
都不是。PagedAttention 是推理引擎(vLLM)实现的软件内存管理算法,类似操作系统里的虚拟内存/页表:它在底层维护一张”块表(Block Table)”,把散落在显存各处的物理块逻辑上拼成一整段连续内存喂给模型。GPU 硬件只认连续物理地址,模型只负责数学计算,”分页”这件事由引擎在两者之间做翻译。这是理解教程最后一段的关键:它解决的是”显存碎片和冗余”这个工程问题,不是模型结构问题。
Q2:为什么 Static / Paged-16 / Paged-64 三个配置结果一模一样?
教程和打卡任务都给出这样一个实验:同一个 ContinuousBatchingModel,只改 page_size(2048 / 16 / 64),跑出来的 Max Users、Throughput、Frag、Speedup 完全相同。我本地复现果然如此(seq_len=32768,max_batch=16):
System             Max Users  Throughput  Frag  Speedup
───────────────────────────────────────────────────────
Static (baseline)         16     632 t/s  0.0%     1.1x
Paged (16 tok)            16     632 t/s  0.0%     1.1x
Paged (256 tok)           16     632 t/s  0.0%     1.1x
三个原因叠加导致”无效”:
seq_len被page_size整除,碎片率天然为 0。 教程默认 seq_len=4096:÷2048=2、÷16=256、÷64=64,全部整除、完美填满,Frag全是 0.0%。PagedAttention 消除的是”浪费”,没有浪费可消除时它当然没有用武之地。max_batch_size强制了并发上限。 三种配置都被同一个上限(16)卡住,显存根本没到瓶颈。- 所有请求同生共死。 模拟器里每个请求一样的长度、一样的生命周期,没有早退的短请求腾出空间——PagedAttention 的”按需分配 + 动态复用”完全没有发挥空间。
我把 seq_len 改成 4000、max_batch_size 调到 1000 让显存成为瓶颈,才终于看到差异:Static 只能塞 130 个、Paged-16 塞 133 个、Paged-64 塞 132 个。差异存在,但远没有想象中大。
Q3:那 PagedAttention 到底什么时候才有大用?
关键认知是:PagedAttention 是”空间”优化,Continuous Batching 是”时间”优化,两者结合才把吞吐放大到极致。
- PagedAttention 消除空间浪费:物理块按需分配、支持前缀共享(多个请求相同的 system prompt 共用同一份 KV)、写时复制。
- Continuous Batching 消除时间浪费:请求谁先完成谁先释放,空位立即让新请求顶上。
- 只有当请求长度呈长尾分布(80% 短请求 + 20% 长请求)时,短请求快速释放显存、PagedAttention 快速填补空隙,两者才产生真正的 1+1>2。模拟器里”请求同生共死”的设定把时间维度的动态性拿掉了,所以空间优化也发挥不出来。
这也解释了教程为什么把 PagedAttention 放在”显存利用率”这节课里讲——它和量化一样,都是在容量墙内部做文章,而不是把墙推倒。
Q4:INT4 加速比随 batch 上升而不是下降?
选做实验 O2 的原文是”展示 FP16 vs INT4 在不同 batch size 下的 ITL 对比,找到 INT4 加速比开始下降的临界 batch size”。我当时的预期是:batch 增大,LLM 推理迟早从访存受限转向计算受限,量化省下的字节不再值钱,加速比应该掉下去。
实测结果(H100, 8B, seq 2048)完全相反:
| Batch | ITL fp16 | ITL int4 | 加速比 |
|---|---|---|---|
| 1 | 5.19 ms | 1.54 ms | 3.38× |
| 2 | 5.27 ms | 1.56 ms | 3.38× |
| 4 | 5.43 ms | 1.60 ms | 3.40× |
| 8 | 5.76 ms | 1.68 ms | 3.43× |
| 16 | 6.40 ms | 1.84 ms | 3.48× |
| 32 | 7.68 ms | 2.16 ms | 3.56× |
| 64 | 10.24 ms | 2.80 ms | 3.66× |
| 128 | 15.37 ms | 4.08 ms | 3.76× |
| 256 | 25.63 ms | 6.65 ms | 3.86× |
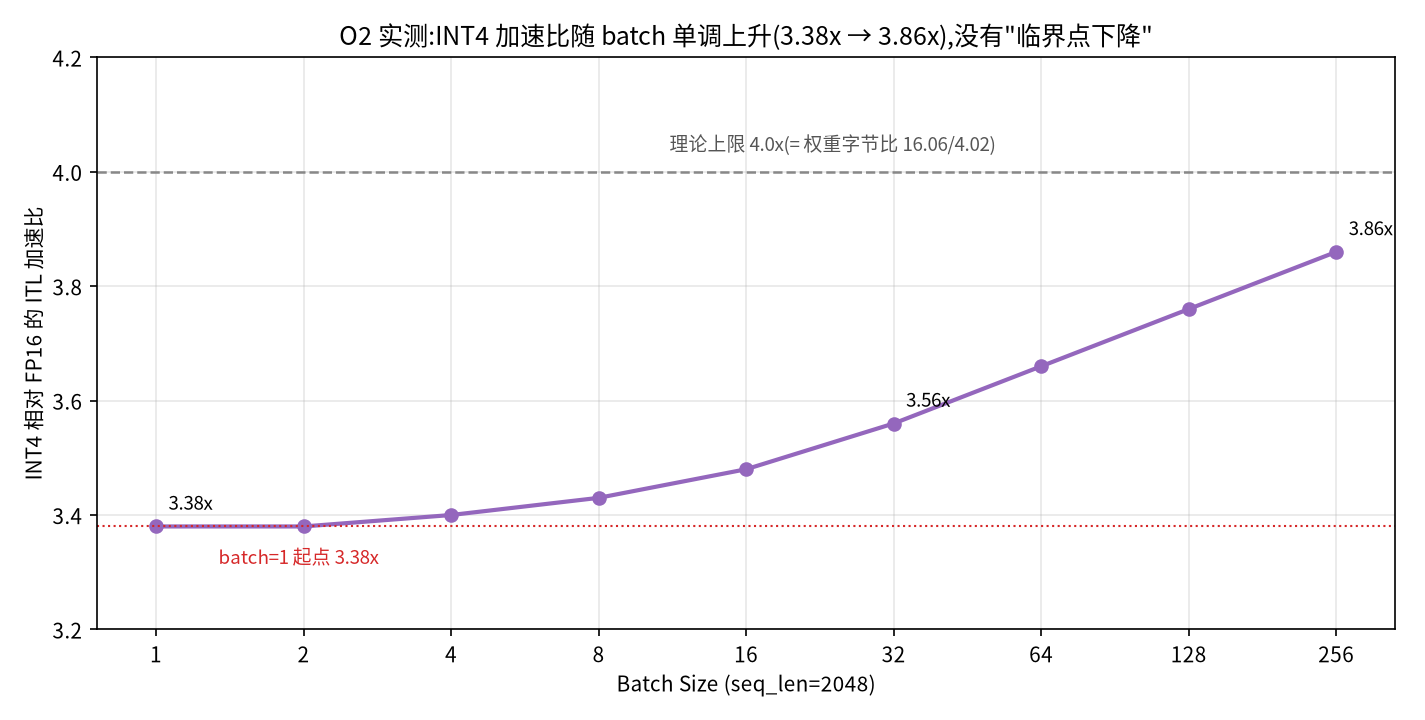
图 4:INT4 相对 FP16 的 ITL 加速比从 batch=1 的 3.38× 单调升到 batch=256 的 3.86×,不存在”临界点下降”。
加速比不降反升,一路逼近理论极限 4×。 两个原因:
- “batch 增大 → 转计算受限”为什么是错的:算术强度会饱和,不是恒为 1。 这个直觉默认分母里只有权重——权重确实只搬一次,计算量确实随 batch 线性涨。把 KV 写进分母就变了:
AI(B) = 2·N·B / (N·b_w + B·KV_req)
小 batch 时权重主导,AI ≈ 2B/b_w,随 batch 线性涨——直觉在这段成立;大 batch 时 KV 主导,AI 收敛到 2N/KV_req,不再增长。seq=2K 时这个饱和值是 60 FLOP/byte(Llama-3-8B:N = 8.03B、KV_req = 0.268 GB),而 H100 的脊点是 295(989 TFLOP/s ÷ 3.35 TB/s,按引擎默认效率 0.5 也要 148),差五倍,永远够不到。不是计算量不够大,是 KV 的访存量跟计算量涨得一样快(都 ∝ B),比值收敛成常数。 ResNet-50 那套”batch 增大翻过脊点”的经验,照搬到 decode 上就失效了。
顺带厘清一个容易混的概念:AI 回答的是”撞哪堵墙”(算力墙还是带宽墙),加速比回答的是”墙内谁占大头”(可压缩的那份占多少)。”永远访存受限”不等于”加速比不变”——墙内数据的构成还会随 batch 变,这就是 Q5 里真实系统加速比会掉的原因:不是翻墙,是墙里换了债主。
- 工具里比值被锁死在 4×。 引擎里 KV-Cache 也随精度缩放(bytes_per_elem 跟 precision 走,INT4 时 KV 也缩到 1/4,见 Q5),FP16 账单是”16.06 GB + B·KV”,INT4 是”4.02 GB + B·KV/4”——每一项都同比例缩小,理论加速比恒等于 4.00×,与 batch 无关。那 3.38→3.86 的”上升”是什么?固定开销被摊薄:每生成一个 token 都有一笔固定的层税(32 层 × 10 μs = 0.32 ms,第一篇挖出来的),小 batch 时它占 ITL 的 6%,把加速比从 4 压到 3.38;batch 越大访存时间越长,这笔税占比越小,加速比单调逼近 4×。工具里没有”加速比上升”的机制,只有摊销。
所以任务书问的那个”临界 batch”,在工具里找不到——是工具的假设让下降看不见:KV 随精度缩放(所有访存项同比例缩小)+ ITL 纯带宽模型(没有算力上限)。真实系统里临界点确实存在,只是降因不是算力,是 KV——见 Q5。
Q5:引擎里 INT4 的 KV-Cache 为什么也跟着缩?
这是 Q4 的延伸。真实部署里,KV-Cache 通常保持 FP16(或单独做 KV 量化),与权重量化是两件事。但 mlsysim 的 ServingModel 把 bytes_per_elem 绑定在 precision 上,INT4 时 KV 每个元素也按 0.5 字节算——所以上面 O2 表里 int4 的 KV(0.070 GB @bs1)是 fp16(0.268 GB)的 1/4。这是引擎的一个简化假设,不是部署习惯。好处是让”量化加速比”这个实验更干净地逼近权重字节比;代价是如果你要模拟真实系统(权重 INT4 + KV FP16),需要手动把 KV 部分补回去。知道引擎替你做了哪些假设,是读文档读不出来的。
那真实部署呢?KV 通常保持 FP16(或单独做 KV 量化),权重量化省不掉它。把 KV 按 FP16 补回去,用同一套带宽模型算”权重 INT4 + KV FP16”——decode 一步搬的字节分两坨:权重是常数、可压缩(16.06 → 4.02 GB);KV 是 0.268 GB × B、不可压缩。于是加速比有个干净的形式——按份额加权的调和平均:
speedup(B) = 1 / (f_w/4 + f_kv)
其中 f_w 是权重在总访存里的份额、f_kv 是 KV 的份额(f_w + f_kv = 1)。只有权重那份能除以 4,KV 那份只能原样留着:
| Batch | 权重份额 f_w | KV 份额 f_kv | 加速比 |
|---|---|---|---|
| 1 | 98.4% | 1.6% | 3.81× |
| 16 | 78.9% | 21.1% | 2.45× |
| 32 | 65.2% | 34.8% | 1.96× |
| 64 | 48.4% | 51.6% | 1.57× |
| 128 | 31.9% | 68.1% | 1.31× |
| 256 | 19.0% | 81.0% | 1.17× |
两组数字合起来看,矛盾就化解了:AI 从 1.0 爬到 48.6(B=256),饱和极限 60,离 H100 脊点 295 还有五倍——始终访存受限(访存耗时一直是算力耗时的 6 倍以上,B=256 时 25.3 ms vs 4.2 ms);而权重份额从 98.4% 掉到 19.0%,加速比跟着从 3.81× 掉到 1.17×。一句话:AI 饱和说明你没翻过那堵墙,加速比下降说明你在墙里被换了债主——可压缩的权重被稀释成常数,压它也就没意义了。
任务书让你找的”临界 batch”在真实系统里确实存在:跌破 2× 在 batch≈30(seq 2K,由 2B·KV = W 推出),上下文越长塌得越早;KV 反超权重的五五开转折点在 batch≈60(8K 时 ≈15,32K 时 ≈4)。工具里看不到这条下降曲线,是因为两条”下降通道”都被关掉了:KV 随精度缩放(所有访存项同比例缩小、分子分母约掉,加速比恒等 4.00×)+ ITL 是纯带宽模型(没有 roofline 天花板,连算力封顶都看不见)。
要模拟真实系统,在脚本二里加两行即可:
# 权重量化、KV 保持 FP16(真实部署习惯)
kv_fp16 = model.get_kv_cache_size(seq_len=2048, batch_size=B, precision="fp16")
total_int4 = model.size_in_bytes("int4") + kv_fp16      # 别用 W_int4 + B*kv_int4
speedup    = (model.size_in_bytes("fp16") + kv_fp16) / total_int4
六、读引擎源码挖出的两个细节
延续前两篇的习惯,把 CompressionModel 和 ServingModel 再扒一遍:
细节一:CompressionModel.solve() 的参数与返回。
CompressionModel.solve(
    model, hardware,
    method="quantization",   # "quantization" | "pruning" | "distillation"
    target_bitwidth=8,       # 4, 8, 16(量化时)
    sparsity=0.0,            # 0.0–1.0(剪枝时)
    sparsity_type="unstructured"  # "unstructured" | "structured" | "n_m"
) → CompressionResult
CompressionResult 的字段: compressed_size_gb(压缩后体积)、compression_ratio、memory_savings_pct、inference_speedup、estimated_accuracy_delta。
细节二:三个字段的语义要分开看。 compression_ratio 和 memory_savings_pct 是同一种东西的两种说法(压缩比 = 1/(1−节省率))。inference_speedup 在量化下等于压缩比、在剪枝下恒为 1.00×——它建模拟的是”decode 阶段搬运字节数的比例”,不是真实算力变化;而 estimated_accuracy_delta 是个查表式的静态估算(本地跑出 -0.00% ~ -0.06%,明显偏乐观),它只适合看方向,不能当评估结论。真实精度损失要跑校准+评估,这超出仿真工具的能力边界——工具的价值是把”存储-时间”的权衡画清楚,把”精度”留给真实评测。
七、个人思考
-
显存的账本是一道乘法题。 KV-Cache 公式里每个因子(层数、KV 头、head_dim、seq_len、batch、位宽)都是纯乘,没有任何共享与摊销。这意味着任何一项翻倍,显存就翻倍——长上下文、大并发、高精度,三个愿望在 80GB 的卡上不可能同时满足。”显存去哪了”的答案就是”被乘数吃掉了”。
-
序列长度是比模型大小更隐蔽的显存杀手。 权重是死的(买卡时一次性付清),KV-Cache 是活的(随每个请求的上下文增长)。130 并发 (4K) 对 4 并发 (128K),同样是 Llama-3-8B 一张 H100,服务形态天差地别。上下文长度是产品决策,它会直接翻译成成本决策——这也是为什么”128K 上下文”在营销上是卖点、在运维上是账单。
-
量化/剪枝解决的是容量,不是带宽。 这句话需要修正一下:量化同时解决两者——decode 阶段省字节就是省搬运时间(带宽墙),总量减小就是省显存(容量墙);非结构化剪枝只解决存储、不解决搬运。选优化手段之前,先问瓶颈在哪一侧:省显存可以剪枝,省时间必须量化(或 2:4 稀疏)。
-
仿真工具的简化假设就是它的边界。 KV 随精度缩放、accuracy_delta 静态估算,都是引擎为了”把机制讲清楚”做的简化。用工具做决策时,必须知道哪些数字是机制(可靠)、哪些是假设(仅供参考)。工具的边界,就是你需要回到真实系统去补实验的地方。 Q4/Q5 就是现成的例子:同一个实验,工具里加速比锁死 4×、真实里掉到 1.2×,差异全部来自”KV 是否随精度缩放”这一个假设——把 KV 补回 FP16,任务书的”临界 batch”立刻出现。
八、参考资料与复现
- 教程链:00 Hello Roofline(第一篇)→ 01 Memory Wall + 02 Two Phases(第二篇)→ 03 KV-Cache: The Hidden Memory Consumer(本篇)→ Quantization: Not a Free Lunch(本篇)。
- 打卡任务:Datawhale llm-algo-leetcode #133。
- 复现方法:
pip install mlsysim,脚本见文末附录。 - KV-Cache 公式与并发推导部分参考了 How much memory is needed for Llama 3 70B? 官方博客。
- 环境:WSL2 + conda 环境 mlsysim(python 3.11,mlsysim 0.1.1),全程无 GPU,纯仿真。
附:完整运行脚本(可直接复制运行)
脚本一:KV-Cache 显存账本(E1+E2+E3)——权重大小、KV-Cache 随序列长度、并发上限,以及 PagedAttention 对照
import mlsysim
from mlsysim.solvers import ServingModel
from mlsysim.show import table, info

model = mlsysim.Models.Language.Llama3_8B
hardware = mlsysim.Hardware.Cloud.H100
solver = ServingModel()

# E1: 不同精度下的权重大小
print("--- Llama-3-8B 权重 ---")
for prec, byte in [("fp16", "2 byte"), ("int8", "1 byte"), ("int4", "0.5 byte")]:
    print(f"{prec}: {model.size_in_bytes(precision=mlsysim.ureg(byte)).to('GB'):.2f} GB")
print(f"70B fp16: {mlsysim.Models.Language.Llama3_70B.size_in_bytes(precision=mlsysim.ureg('2 byte')).to('GB'):.1f} GB (H100 = {hardware.memory_capacity.to('GB'):.1f} GB)")

# E2: 单请求 KV-Cache 随序列长度
from mlsysim.core import calc_kv_cache_size
rows = []
for ctx in [2048, 4096, 32768, 131072]:
    kv = calc_kv_cache_size(n_layers=model.layers, n_heads=model.kv_heads,
                            head_dim=model.hidden_dim // model.heads,
                            seq_len=ctx, batch_size=1, bytes_per_elem=2)
    rows.append([ctx, f"{kv.to('MB'):.0f} MB"])
table(["SeqLen", "KV per request"], rows)

# E3: 并发上限扫描(feasible)
rows = []
for ctx in [2048, 4096, 32768, 131072]:
    best = 0
    for b in range(1, 1500):
        r = solver.solve(model=model, hardware=hardware, seq_len=ctx, batch_size=b, precision="fp16")
        if r.feasible:
            best = b
        else:
            break
    rows.append([ctx, best])
table(["SeqLen", "Max concurrent"], rows)

# PagedAttention 对照(为什么三个配置一样:seq_len 被 page_size 整除 + max_batch 封顶)
from mlsysim.solvers import ContinuousBatchingModel
cb = ContinuousBatchingModel()
rows = []
for label, page in [("Static", 2048), ("Paged 16", 16), ("Paged 256", 256)]:
    c = cb.solve(model=model, hardware=hardware, seq_len=32768,
                 max_batch_size=16, page_size=page, precision="fp16")
    rows.append([label, c.max_active_requests, f"{c.throughput_tokens_per_sec:.0f} t/s",
                 f"{c.memory_fragmentation_pct:.1f}%", f"{c.speedup_vs_static:.1f}x"])
table(["System", "Max Users", "Throughput", "Frag", "Speedup"], rows)
脚本二:量化与压缩(O1+O2+O3)——8B→70B、INT4 加速比随 batch、CompressionModel 量化 vs 剪枝
import mlsysim
from mlsysim.solvers import ServingModel, CompressionModel
from mlsysim.show import table

model = mlsysim.Models.Language.Llama3_8B
hardware = mlsysim.Hardware.Cloud.H100
solver = ServingModel()

# O1: 8B → 70B 两阶段放大
for m in [model, mlsysim.Models.Language.Llama3_70B]:
    r = solver.solve(model=m, hardware=hardware, seq_len=2048, batch_size=1, precision="fp16")
    print(f"{m.name}: TTFT {r.ttft.to('ms')}  ITL {r.itl.to('ms')}  weights {r.model_weights_size}")

# O2: INT4 加速比随 batch(结论:单调升,无临界点)
rows = []
for b in [1, 2, 4, 8, 16, 32, 64, 128, 256]:
    r16 = solver.solve(model=model, hardware=hardware, seq_len=2048, batch_size=b, precision="fp16")
    r4 = solver.solve(model=model, hardware=hardware, seq_len=2048, batch_size=b, precision="int4")
    rows.append([b, r16.itl.to("ms"), r4.itl.to("ms"),
                 f"{r16.itl.to('ms').magnitude / r4.itl.to('ms').magnitude:.2f}x"])
table(["Batch", "ITL fp16", "ITL int4", "Speedup"], rows)

# O3: 量化 vs 剪枝(压缩比-精度权衡)
cs = CompressionModel()
rows = []
for bits in [16, 8, 4]:
    c = cs.solve(model=model, hardware=hardware, method="quantization", target_bitwidth=bits)
    rows.append([f"Q-{bits}bit", c.compressed_size_gb, f"{c.compression_ratio:.1f}x",
                 f"{c.estimated_accuracy_delta:+.2f}%", f"{c.inference_speedup:.2f}x"])
for sp in [0.5, 0.75, 0.9]:
    c = cs.solve(model=model, hardware=hardware, method="pruning", sparsity=sp, sparsity_type="unstructured")
    rows.append([f"Prune {sp:.0%}", c.compressed_size_gb, f"{c.compression_ratio:.1f}x",
                 f"{c.estimated_accuracy_delta:+.2f}%", f"{c.inference_speedup:.2f}x"])
table(["Method", "Compressed", "Ratio", "Acc Delta", "Speedup"], rows)
如果这篇笔记对你有帮助,欢迎交流。
-
Previous
内存墙与两阶段:为什么 3.2 倍算力只换来 1.6 倍加速The Memory Wall & Two Phases: Why 3.2x More FLOPS Buys Only 1.6x Speedup -
Next
KV-Cache 的显存账本:长上下文、并发与量化剪枝的取舍The KV-Cache Memory Ledger: Long Context, Concurrency, and the Quantization–Pruning Trade-off
If this post helped you, a coffee is always welcome ☕
