昨天在 MLSys·im Roofline 教程学习笔记里,我用 5 行代码学会了用算术强度和脊点判断一个负载是计算受限还是内存受限。今天进入 Datawhale mlsysim 学习活动的第二阶段(对应 Memory Wall 和 Two Phases, One Request 两篇教程),把昨天的”静态”roofline 推向两个更贴近生产的问题:升级硬件到底能快多少?一次 LLM 请求内部,瓶颈是怎么随 token 变化的?
一、Memory Wall:绑定的天花板决定加速比
昨天的 roofline 告诉我们:任何负载都撞在两个天花板中先到的那一个。今天的问题更进一步——换更强的卡,加速比到底跟哪个 spec 走?
教程给了一张非常提神的对照表:
| 约束 regime | 绑定资源 | 加速比 |
|---|---|---|
| Memory-Bound | HBM 带宽 (TB/s) | 两卡的带宽比 |
| Compute-Bound | 峰值算力 (FLOP/s) | 两卡的算力比 |
再看 A100 → H100 的规格:
| 规格 | A100 | H100 | 比值 |
|---|---|---|---|
| FP16 峰值算力 | 312 TFLOP/s | 989 TFLOP/s | 3.2× |
| HBM 带宽 | 2.04 TB/s | 3.35 TB/s | 1.7× |
| 脊点 (FLOP/byte) | 153.0 | 295.2 | — |
算力涨了 3.2 倍,带宽只涨了 1.7 倍。很容易得出结论:只要你的负载是内存受限的,换 H100 的加速上限就是 1.7×,那多出来的 1.5× 算力一分钱都兑现不了。
用 Llama-3-8B 在 batch=1 上验证(FP16 权重 = 8B × 2B = 16 GB):
| A100 | H100 | 加速比 | |
|---|---|---|---|
| 瓶颈 | Memory | Memory | — |
| 延迟 | 9.00 ms | 5.60 ms | 1.6× |
| 吞吐 | 111.1 tok/s | 178.5 tok/s | — |
做个 sanity check:16 GB ÷ 2.04 TB/s ≈ 8.0 ms,16 GB ÷ 3.35 TB/s ≈ 4.8 ms——引擎报的延迟就是”把权重从 HBM 搬一遍”的时间,和带宽比完全吻合。这就是内存墙:GPU 的算力在饿着肚子等数据,而你为算力付了 3.2 倍的钱。
更值得警惕的是趋势。教程把三代 GPU 放在一起:
| GPU | TFLOP/s | BW (TB/s) | 脊点 | 8B bs=1 延迟 | 瓶颈 |
|---|---|---|---|---|---|
| V100 | 125.0 | 0.90 | 138.9 | 19.97 ms | Memory |
| A100 | 312.0 | 2.04 | 153.0 | 9.00 ms | Memory |
| H100 | 989.0 | 3.35 | 295.2 | 5.60 ms | Memory |
算力每代翻倍,带宽只涨一半,脊点被越顶越高——这意味着新硬件上有越来越多的生产负载落在内存受限这一侧。内存墙不是”过去的问题”,它在逐年变厚。
二、我的复现:全 Memory-Bound 的 batch 扫描与”平台期”
任务要求(E1+E2)扫 batch size 找 A100 和 H100 各自的脊点交叉点。我把 batch 从 1 一路扫到 8192:
| Batch | A100 瓶颈 | H100 瓶颈 | 加速比 | A100 吞吐 (tok/s) | H100 吞吐 (tok/s) |
|---|---|---|---|---|---|
| 1 | Memory | Memory | 1.6× | 111.1 | 178.5 |
| 4 | Memory | Memory | 1.6× | 352.1 | 568.0 |
| 16 | Memory | Memory | 1.6× | 768.7 | 1,250.5 |
| 64 | Memory | Memory | 1.6× | 1,091.8 | 1,787.4 |
| 256 | Memory | Memory | 1.6× | 1,219.9 | 2,002.3 |
| 1024 | Memory | Memory | 1.6× | 1,256.8 | 2,064.4 |
| 4096 | Memory | Memory | 1.6× | 1,266.4 | 2,080.5 |
| 8192 | Memory | Memory | 1.6× | 1,268.0 | 2,083.2 |
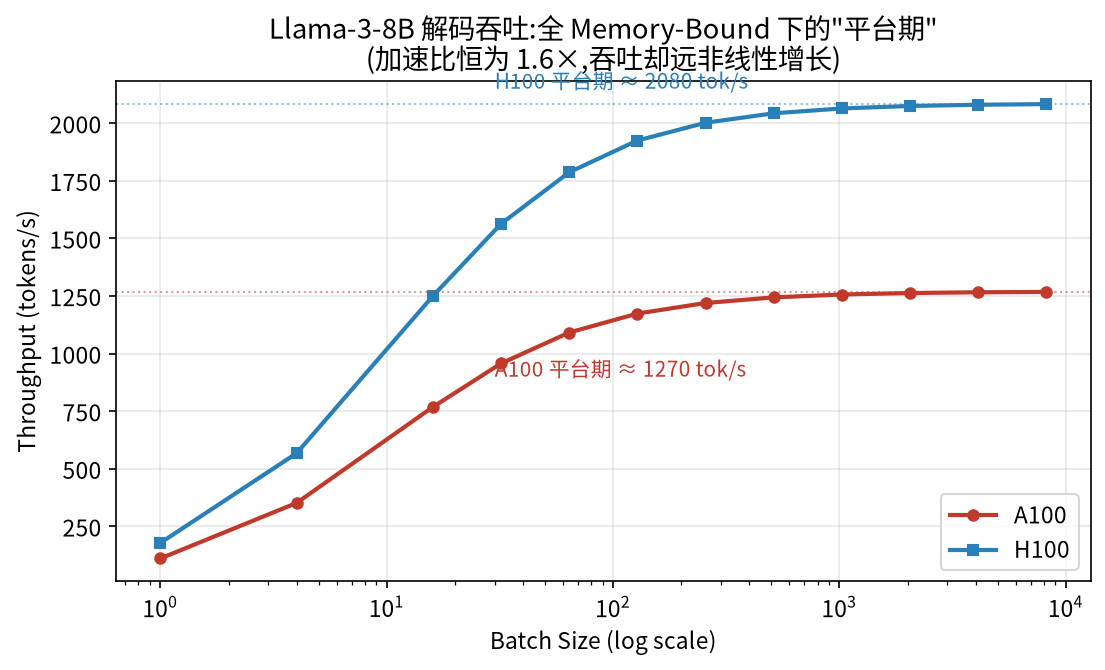
图 1:扫到 8192 全程 Memory-Bound,加速比恒定 1.6×(=带宽比)。吞吐在 batch≈256 后进入平台期,远非线性增长。
三个发现:
- 从头到尾找不到交叉点。 这跟昨天 ResNet-50 的体验完全不同——昨天 batch=2 就翻成 Compute。原因:LLM 解码是自回归的,每个 token 都要把全部权重从 HBM 过一遍,算术强度恒为 1 FLOP/byte 量级(8B 模型:每 token 做 2P FLOP,搬 2P 字节),离 A100 的 153、H100 的 295 差了两个数量级。decode 的脊点交叉在现实 batch 范围内不存在,想靠加大 batch 喂饱算力,先把显存放满再说。
- 加速比恒定 1.6×。 两卡全程 Memory-Bound,比拼的是带宽比 3.35/2.04 ≈ 1.64。这就是第一节结论的现场版。
- 吞吐不是线性增长,存在平台期。 batch 从 1 到 8192,吞吐只从 111 涨到 1268(约 11 倍),而 batch 涨了 8192 倍。这引出了我今天的第一个问题——见第五节 Q1。
三、Two Phases, One Request:一次请求,两堵墙
Memory Wall 说的是”换卡快不快”,Two Phases 回答的是“同一个模型同一张卡,为什么第一个 token 和第 100 个 token 的瓶颈完全不同”。
LLM 生成是自回归的,一次请求天然分成两段:
- Prefill(预填充):把整个 prompt(比如 2048 个 token)一次性并行前向,算出第一个 token。所有输入 token 同时参与计算,把 GPU 算力喂得很满——撞的是算力墙。它的延迟就是 TTFT(Time To First Token)。
- Decode(解码):之后每个 token 单独做一次完整前向,但只处理 1 个新 token,却要把全部权重(8B 参数 = 16 GB)从 HBM 搬一遍——撞的是内存墙。它的延迟就是 ITL(Inter-Token Latency)。
教程里的关键句:prefill 的算术强度约 2048 FLOP/byte(2048 个 token 并行,权重复用 2048 次),远高于 H100 脊点 295;decode 约 1 FLOP/byte,远低于脊点。同一份权重,同一次加载,两个完全不同的运行区间。
之前的 Engine.solve 把推理当成一次前向,给一个笼统的延迟。两阶段场景要用 ServingModel——它把两段分开建模,直接输出 TTFT 和 ITL:
from mlsysim.solvers import ServingModel
solver = ServingModel()
r = solver.solve(model=model, hardware=hardware, seq_len=2048, batch_size=1, precision="fp16")
# TTFT prefill: 70.97 ms   ITL per token: 5.19 ms
两个数字,两个故事。更关键的是,这两个指标对硬件升级的响应完全不对称。教程用 8B 跨三代 GPU:
| GPU | TFLOP/s | BW (TB/s) | TTFT (ms) | ITL (ms) |
|---|---|---|---|---|
| A100 | 312 | 2.04 | 225.0 | 8.33 |
| H100 | 989 | 3.35 | 70.97 | 5.19 |
| H200 | 989 | 4.80 | 70.97 | 3.72 |
- A100 → H100:算力 3.2× → TTFT 改善 ~3×;带宽 1.7× → ITL 改善 ~1.7×。
- H100 → H200:算力没变 → TTFT 纹丝不动;带宽 1.4× → ITL 改善 1.4×。
我在 H100 上用 70B 模型复现(O3:模型规模放大对两阶段的影响),规律完全一致:
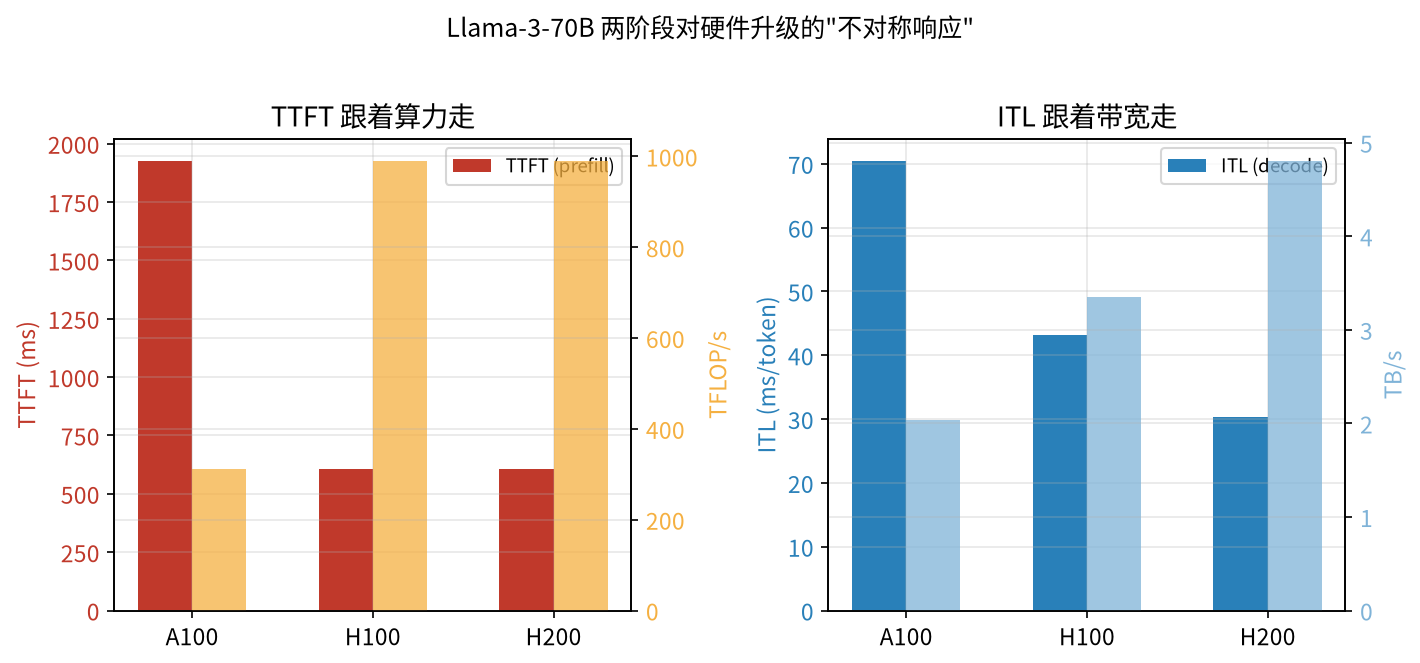
图 2:Llama-3-70B 在 A100/H100/H200 上,TTFT 严格跟随算力(989 不变则 607ms 不变),ITL 严格跟随带宽(3.35→4.80 TB/s 时 43.15→30.36 ms)。
| GPU | TFLOP/s | BW (TB/s) | TTFT (ms) | ITL (ms) |
|---|---|---|---|---|
| A100 | 312 | 2.04 | 1,924.2 | 70.38 |
| H100 | 989 | 3.35 | 607.0 | 43.15 |
| H200 | 989 | 4.80 | 607.0 | 30.36 |
70B 把两堵墙都放大了:FP16 权重 141.2 GB,TTFT 直接到秒级(600ms 起步),ITL 也翻了 8 倍(8B 的 5.19 → 70B 的 43.15)。顺便说一句,引擎给的 Memory utilization 是 165.2%——70B FP16 单卡 H100(80GB)根本放不下,这其实是内存墙的另一种形态:容量墙,后面第五节会再提。
这条”TTFT 只跟算力走、ITL 只跟带宽走”的解耦规律,是整个 LLM serving 成本分析的出发点。
四、量化:救 Decode,不救 Prefill
既然 decode 每个 token 都要把权重全量搬一遍,那把权重变小不就直接加速了吗?这就是量化的逻辑。教程用 8B 验证(O2):
| 精度 | TTFT (ms) | ITL (ms) | 权重 |
|---|---|---|---|
| fp16 | 70.97 | 5.19 | 16.06 GB |
| int8 | 35.47 | 2.76 | 8.03 GB |
| int4 | 70.97 | 1.54 | 4.02 GB |
我 70B 的复现(权重 141.2 → 70.6 → 35.3 GB):
| 精度 | TTFT (ms) | ITL (ms) | 权重 |
|---|---|---|---|
| fp16 | 607.0 | 43.15 | 141.2 GB |
| int8 | 303.4 | 21.97 | 70.60 GB |
| int4 | 607.0 | 11.39 | 35.30 GB |
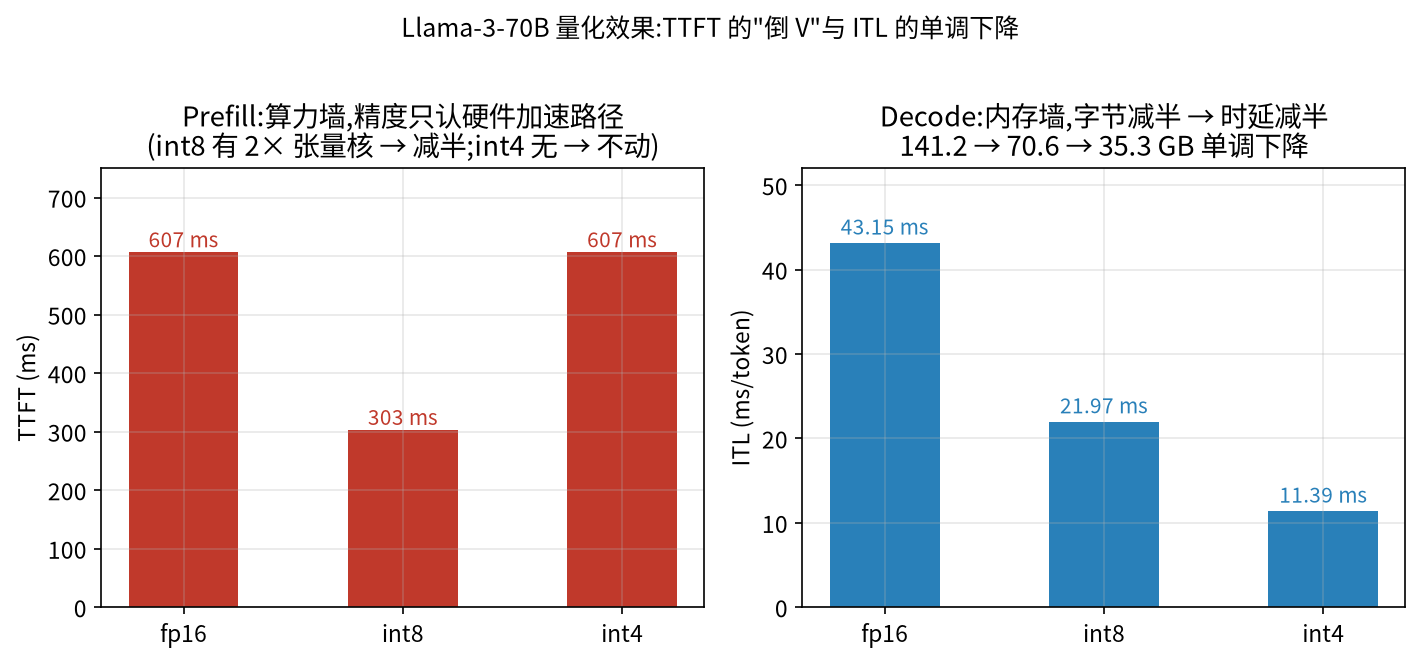
图 3:ITL 随字节数单调下降(内存墙,字节减半时延减半);TTFT 却呈”倒 V”——int8 减半、int4 打回原形。
两个规律都非常清晰:
- Decode 侧:权重字节数减半,ITL 就减半。 5.19 → 2.76 → 1.54;43.15 → 21.97 → 11.39。因为 decode 是”每 token 全量搬权重”,字节数就是命门。
- Prefill 侧:出现了反直觉的”倒 V”。 int8 时 TTFT 减半(70.97→35.47,607→303.4)——似乎量化也救了 prefill;但 int4 时 TTFT 又”回升”到 fp16 水平。这看起来完全违背”权重变小应该更快”的直觉,却是今天最有技术含量的问题(第五个疑惑,第五节 Q5 给根因)。
一句话总结:量化主要救 decode;prefill 是算力墙,权重变小不等于算得快,除非硬件真的有对应的低精度算力路径。
五、学习过程中的疑惑与解答
Q1:全 Memory-Bound 时,为什么吞吐量不是线性增长,而是增长越来越慢?(扫 batch 时最先注意到)
这是我今天问出的第一个问题。直觉上:既然都是内存受限,每样本的访存量固定,吞吐应该随 batch 线性涨才对;只有越过脊点转 Compute-Bound 后,吞吐才应该”饱和”。
答案分三段:小 batch 时,固定开销(调度税 + 每层框架税)主导,吞吐被压在低位;batch 增大,固定开销被摊薄,吞吐迎来一段近似线性的快速增长;大 batch 时,还没等算力吃饱,显存带宽已经被权重的全量搬运(加上线性增长的 KV Cache)榨干,吞吐进入平台期。实测数据完美印证:A100 上 batch 1→16 吞吐涨了 7 倍,16→64 只涨 1.4 倍,1024→8192 基本不动(1256→1268)。“Memory-Bound” 不等于”吞吐线性”——固定开销和平台期是两码事,这个区分是我今天最大的手感收获之一。
Q2:batch_size 不应该是硬件特性吗?为什么打卡要求问”A100 和 H100 的 Ridge Point 分别是多少?为什么不同?”
脊点 = 峰值算力 ÷ 峰值带宽,是硬件常数,与 batch 无关:A100 ≈ 153 FLOP/byte,H100 ≈ 295 FLOP/byte——不同是因为两代卡的算力/带宽比不同(H100 把 3.2× 的算力配了 1.7× 的带宽,脊点被顶高)。
那 batch 影响什么?影响工作负载的算术强度:权重只从显存读一次,却被 batch 内所有样本复用,所以 batch 越大,FLOPs 线性涨、Bytes 几乎不动,算术强度上升,工作点沿 roofline 斜线向右移动,直到越过脊点进入计算受限区。脊点是硬件的地形,算术强度是负载的位置——batch 是改变位置的那个旋钮。问题本身的混淆点在于把”负载属性”当成了”硬件属性”。
Q3:教程说 TTFT 是几十毫秒(由 989 TFLOP/s 算力天花板主导),ITL 是一毫秒的几分之一(由 3.35 TB/s 带宽天花板主导)——这些数字到底怎么算出来的?
拿 Llama-3-8B(32 层、4096 隐藏维、seq_len=2048、H100、efficiency=0.5)手算一遍:
- Prefill 线性层:2 × 参数 × token 数 = 2 × 8.03B × 2048 ≈ 32.9 TFLOP;注意力(softmax 前的 QK^T 与 AV):约 2.2 TFLOP;总 ≈ 35 TFLOP。
- TTFT = 35 TFLOP ÷ (989 TFLOP/s × 0.5) ≈ 70.97 ms——和引擎输出一字不差。
- ITL = 16.06 GB ÷ 3.35 TB/s ≈ 4.8 ms(权重全量搬运;加上 KV Cache 0.268 GB 和每层框架税,合计 ≈ 5.19 ms)。
验证方法更漂亮(助教给的”扰动实验”):把算力 ×2、带宽不变 → TTFT 减半、ITL 不动;把带宽 ×2、算力不变 → ITL 减半、TTFT 不动。哪一个指标被扰动撼动,就证明它由哪一个天花板主导——两行对照,双墙理论一目了然。
Q4:decode 的算术强度,为什么是”每 token 2P 次 FLOP、搬 2P 字节”?权重不是只有 P 个参数吗?
这是单位换算的坑:P 是参数个数,2P 字节是 FP16 下的体积——每个参数占 2 字节。8B 参数 = 16 GB = 2P 字节。于是每 token:FLOPs = 2P(每个权重做一次乘加,按 1 MAC = 1 FLOP 口径),Bytes = 2P,算术强度 = 2P ÷ 2P = 1 FLOP/byte。KV Cache 是额外的负担,但在 16 GB 权重面前(0.27 GB)可忽略。我之前的疑惑是把”参数个数”和”字节数”两个单位混在一起了。
Q5:为什么 fp16 → int8,TTFT 减半;再切 int4,TTFT 又升回去了?权重精度不是不该影响算力墙吗?
这是今天最反直觉的问题,读引擎源码才找到根因。ServingModel 的 prefill 算力是这么取的:
peak_flops_prefill = hardware.compute.precision_flops.get(precision, hardware.compute.peak_flops)
即按精度查硬件的”低精度算力表”,查不到就回退到 FP16 峰值。看 H100 这张表:
H100: {'tf32': 494, 'fp8': 1979, 'int8': 1979}   # 无 int4!
B200: {'fp8': 4500, 'int4': 9000}                # B200 才有 int4
- int8:表里有 1979 TFLOP/s(= 2 × 989),所以 TTFT 减半——引擎忠实模拟了 H100 的 INT8 张量核加速路径。
- int4:表里没有 → 回退 989,TTFT 回到 fp16 水平——H100 的硬件事实就是没有原生的 INT4 稠密加速,INT4 通常要打包成 INT8 来算;直到 B200,INT4 才有 9000 TFLOP/s 的官方算力。
所以这个”倒 V”不是引擎的 bug,而是仿真工具忠实于硬件表、硬件表忠实于真实硬件的体现。量化在 decode 侧立竿见影(字节就是命门),在 prefill 侧则完全取决于硬件有没有对应的低精度算力路径——这恰恰解释了生产里”int4 权重 + fp16 计算”混合精度方案盛行的原因。
Q6:Two Phases 的 Exercise 2(chatbot vs summarizer 场景分析)没法指定 input 和 output token 数,怎么做实验?
ServingModel.solve 只接受 seq_len 一个长度参数,确实没有分开的 input/output 参数。我绕了一圈后自己想通了:生成总时延 = TTFT(prefill 全部 input)+ N × ITL(每个 output token 一步),所以只要分别拿 TTFT 和 ITL 乘就行——chatbot(50 input / 500 output)总时延 ≈ TTFT + 500 × ITL;summarizer(4000 input / 100 output)≈ TTFT + 100 × ITL。这也顺便把 Exercise 2 的结论推出来了:chatbot 是 ITL 主导(买带宽),summarizer 是 TTFT 主导(买算力)。
六、读源码挖出的三个细节
延续昨天的习惯,把 ServingModel 的公式和硬件表扒开看:
细节一:两阶段的完整公式。
# Prefill: 线性层 2P·S + 注意力 4·L·H·(d/H)·S²,除以"精度算力 × 效率",再加调度税
prefill_ops = (2·P·S + 4·L·H·head_dim·S²) · batch
t_prefill = prefill_ops / (peak_flops_prefill × efficiency) + dispatch_tax

# Decode: 每 token 把"权重 + KV Cache"全量搬一遍,再加每层框架税
t_decode_per_token = (weights_bytes + kv_cache_bytes) / bandwidth + layers × 10μs
两个值得注意的点:一是 prefill 显式包含 O(S²) 的注意力项——长上下文时 attention 的计算量会反超线性层,这正是”KV Cache 隐藏税”和长文本场景的伏笔;二是 decode 每 token 也收层税(32 层 × 10μs ≈ 0.32ms),固定开销在 decode 上同样存在,这也是为什么小模型在小 batch 下 ITL 实测会比纯带宽估算高。
细节二:prefill 的算力是按精度查表的——precision_flops.get(precision, peak_flops)。这就是 Q5 的根因,也是”仿真工具的默认参数和硬件表就是模型的一部分”最生动的一课:不看源码,你根本不知道引擎替硬件做了哪些假设。
细节三:内存墙有两种形态——带宽墙和容量墙。 70B FP16 推理时引擎报 Memory utilization 165.2%,单卡 H100 放不下。容量墙决定”一张卡能服务多大的模型/多少个并发”,带宽墙决定”每个 token 有多快”。昨天关注的是带宽墙,今天发现容量墙对部署形态(张量并行、量化、KV Cache 上限)的约束同样致命。
七、个人思考
-
内存墙在逐年变厚,采购决策要先问 regime。 三代 GPU 脊点从 138.9 涨到 295.2,意味着同样一个负载,在新硬件上更可能落在内存受限侧。”换更强的卡”在 memory-bound 负载上等于按带宽比花钱——先回答”我的生产负载在屋顶的哪一侧”,再谈买哪张卡。
-
“一次请求两堵墙”是 serving 成本分析的地基。 一个 LLM 请求的延迟预算 = TTFT + N×ITL,两段各撞各的墙。chatbot(短 prompt、长回答)ITL 主导 → 买带宽;summarizer(长文档、短输出)TTFT 主导 → 买算力。同一个模型,业务形态不同,正确的采购策略可以完全相反。
-
量化救 decode 不救 prefill,这解释了混合精度方案的盛行。 int4 权重把 decode 的搬运量砍到 1/4,而 prefill 靠 fp16 计算保精度和速度——两个阶段各用各的精度,正是这套”不对称”理论的工程化落地。
-
仿真工具的硬件表就是模型的一部分。 int4 时 TTFT 回升不是 bug,是 H100 没有 INT4 原生算力这个硬件事实的忠实投影。用仿真工具做决策前,先搞清楚它的默认参数和硬件规格表替你做了哪些假设——这是连续两天读源码最大的共同收获。
-
一阶分析能在花一分钱之前给出决策边界。 SLA 选型实验(教程 8B:TTFT<200ms 时 T4/A100 出局、H100/H200 通过;我 70B 的版本 TTFT<500ms 全军覆没)说明:这类分析的价值不在精确预测,而在把”哪些卡根本不用考虑”提前划掉。
八、下一步与参考资料
- 教程链:00 Hello Roofline(上一篇)→ 01 The Memory Wall(本篇) → 02 Two Phases, One Request(本篇)→ KV-Cache: The Hidden Tax(并发上限)→ Quantization: Not a Free Lunch → The $9M Question。
- 打卡任务:Datawhale llm-algo-leetcode #83
- 复现方法:
pip install mlsysim,脚本见文末附录。 - 环境:WSL2 + conda 环境 mlsysim(python 3.11,mlsysim 0.1.1),全程无 GPU。
附:完整运行脚本(可直接复制运行)
脚本一:内存墙实验(E1+E2)——Llama-3-8B 在 A100/H100 上的 batch 扫描与脊点寻找
import mlsysim
from mlsysim import Engine
from mlsysim.show import table

a100 = mlsysim.Hardware.Cloud.A100
h100 = mlsysim.Hardware.Cloud.H100

flops_a = a100.compute.peak_flops.to("TFLOPs/s").magnitude
flops_h = h100.compute.peak_flops.to("TFLOPs/s").magnitude
bw_a = a100.memory.bandwidth.to("TB/s").magnitude
bw_h = h100.memory.bandwidth.to("TB/s").magnitude

print(f"A100: {flops_a} TFLOP/s, {bw_a} TB/s, ridge = {flops_a/bw_a:.1f} FLOP/byte")
print(f"H100: {flops_h} TFLOP/s, {bw_h} TB/s, ridge = {flops_h/bw_h:.1f} FLOP/byte")

model = mlsysim.Models.Language.Llama3_8B

# 单点对比:batch=1,验证"3.2× 算力只换 1.6× 加速"
pa = Engine.solve(model=model, hardware=a100, batch_size=1, precision="fp16")
ph = Engine.solve(model=model, hardware=h100, batch_size=1, precision="fp16")
print(f"A100: {pa.bottleneck}, {pa.latency.to('ms')}, {pa.throughput}")
print(f"H100: {ph.bottleneck}, {ph.latency.to('ms')}, {ph.throughput}")
print(f"Speedup = {pa.latency.to('ms').magnitude / ph.latency.to('ms').magnitude:.1f}x")

# batch 扫描:找 crossover(结论:LLM decode 全程 memory-bound,无交叉点)
rows = []
for batch in [1, 4, 16, 32, 64, 128, 256, 512, 1024, 2048, 4096, 8192]:
    pa = Engine.solve(model=model, hardware=a100, batch_size=batch, precision="fp16")
    ph = Engine.solve(model=model, hardware=h100, batch_size=batch, precision="fp16")
    la = pa.latency.to("ms").magnitude
    lh = ph.latency.to("ms").magnitude
    sp = la / lh if lh > 0 else 0
    rows.append([batch, pa.bottleneck, ph.bottleneck, f"{sp:.1f}x", pa.throughput, ph.throughput])

table(["Batch", "A100 Bottleneck", "H100 Bottleneck", "Speedup", "A100 Throughput", "H100 Throughput"], rows)
脚本二:两阶段实验(E3+E4+O2+O3+O4)——ServingModel 的 TTFT/ITL 分析、量化对比与 SLA 选型
import mlsysim
from mlsysim.solvers import ServingModel
from mlsysim.show import table, info

# Llama-3-70B(想跑 8B 就换成 mlsysim.Models.Language.Llama3_8B)
model = mlsysim.Models.Language.Llama3_70B
hardware = mlsysim.Hardware.Cloud.H100

solver = ServingModel()
result = solver.solve(
    model=model,
    hardware=hardware,
    seq_len=2048,       # 2K token context window
    batch_size=1,       # single user
    precision="fp16"
)

info("Phase Analysis",
     TTFT_prefill=result.ttft.to('ms'),
     ITL_per_token=result.itl.to('ms'))

info("Memory Budget",
     Model_weights=result.model_weights_size,
     KV_cache=result.kv_cache_size,
     Memory_utilization=f"{result.memory_utilization:.1%}")

# E4:跨代对比——TTFT 只跟算力走,ITL 只跟带宽走
gpus = [
    ("A100", mlsysim.Hardware.Cloud.A100),
    ("H100", mlsysim.Hardware.Cloud.H100),
    ("H200", mlsysim.Hardware.Cloud.H200),
]
rows = []
for name, hw in gpus:
    r = solver.solve(model=model, hardware=hw, seq_len=2048, batch_size=1, precision="fp16")
    rows.append([name, hw.compute.peak_flops.to("TFLOPs/s"),
                 hw.memory.bandwidth.to("TB/s"), r.ttft.to('ms'), r.itl.to('ms')])
table(["GPU", "TFLOP/s", "BW (TB/s)", "TTFT (ms)", "ITL (ms)"], rows)

# O2:量化对比——ITL 单调下降(字节减半),TTFT 只认硬件低精度算力路径
rows = []
for prec in ["fp16", "int8", "int4"]:
    r = solver.solve(model=model, hardware=hardware, seq_len=2048, batch_size=1, precision=prec)
    rows.append([prec, r.ttft.to('ms'), r.itl.to('ms'), r.model_weights_size])
table(["Precision", "TTFT (ms)", "ITL (ms)", "Weights"], rows)

# O4:SLA 选型——给定 TTFT<500ms、ITL<50ms,看哪张卡能满足(70B 下全部 FAIL)
gpus_all = [
    ("T4",   mlsysim.Hardware.Cloud.T4),
    ("A100", mlsysim.Hardware.Cloud.A100),
    ("H100", mlsysim.Hardware.Cloud.H100),
    ("H200", mlsysim.Hardware.Cloud.H200),
]
TTFT_SLA, ITL_SLA = 500, 50  # ms
rows = []
for name, hw in gpus_all:
    r = solver.solve(model=model, hardware=hw, seq_len=4096, batch_size=1, precision="fp16")
    ttft = r.ttft.to("ms").magnitude
    itl = r.itl.to("ms").magnitude
    rows.append([name, f"{ttft:.1f} ms", f"{itl:.2f} ms",
                 "✓" if ttft <= TTFT_SLA else "✗",
                 "✓" if itl <= ITL_SLA else "✗",
                 "PASS" if ttft <= TTFT_SLA and itl <= ITL_SLA else "FAIL"])
table(["GPU", "TTFT", "ITL", "TTFT OK?", "ITL OK?", "Verdict"], rows)
如果这篇笔记对你有帮助,欢迎交流。
-
Previous
内存墙与两阶段:为什么 3.2 倍算力只换来 1.6 倍加速The Memory Wall & Two Phases: Why 3.2x More FLOPS Buys Only 1.6x Speedup -
Next
KV-Cache 的显存账本:长上下文、并发与量化剪枝的取舍The KV-Cache Memory Ledger: Long Context, Concurrency, and the Quantization–Pruning Trade-off
If this post helped you, a coffee is always welcome ☕
