上一篇 KV-Cache 的显存账本 把视线从”时间”转向”空间”,算清了显存的去向。今天进入 Datawhale mlsysim 学习活动的第四阶段,把视角从”单点性能分析”(Task 1-3)扩展到系统性优化。对应三篇教程:04 Starving the GPU、12 Design Space Exploration、以及选读的 Module 2: Advanced Single-Node Analysis。核心问题很直接:GPU 利用率只有 40% 时,问题往往不在 GPU 本身——那瓶颈到底藏在哪?
一、从”单点瓶颈”到”全链路流水线”
前三篇我们一直在单点分析:roofline 判断负载是计算受限还是内存受限,内存墙量化硬件升级的收益,KV-Cache 算清显存账本。但真实系统里,一个训练步从来不是 GPU 单独完成的,它是一条流水线:
存储 I/O(把样本从磁盘搬进内存)→ CPU 预处理(解码、增强)→ GPU 计算
三个环节串联,整体吞吐由最慢的一环决定:
t_step = max(t_io, t_cpu, t_gpu)      # 步耗时由最慢环节决定
U      = t_gpu / t_step               # GPU 利用率
这就是数据墙(Data Wall)的核心直觉:GPU 再快,如果前面的环节喂不饱数据,整体吞吐量也上不去。 本阶段就用 mlsysim 的三个模型,把这条流水线逐段检查一遍。
二、E1:先找到 GPU 的”天花板”
第一件事是确定基准:ResNet-50 在 A100 上、batch=256、FP16,纯 GPU 计算到底多快?这将是后续所有环节的对照”基线”。
model = mlsysim.Models.Vision.ResNet50
hardware = mlsysim.Hardware.Cloud.A100
solver = SingleNodeModel()
profile = solver.solve(model=model, hardware=hardware, batch_size=256, precision="fp16")
实测结果:
| 指标 | 数值 |
|---|---|
| 单步延迟 | 13.97 ms |
| 吞吐(天花板) | 18,323 img/s |
| 瓶颈类型 | Compute(计算受限) |
意味着 GPU 每秒能”吃”下 1.8 万张图。记住这个数,它是后面所有对比的标尺。
三、E2:存储 I/O 扛得住吗
GPU 需要的数据要先从存储搬进内存。假设每张图是 500KB 的 JPEG(ImageNet 平均水平),batch=256 时一个 step 的数据量是 256 × 500KB = 128MB,而 GPU 每 13.97ms 就要一份——换算成带宽需求:
需求带宽 = 256 × 500KB ÷ 13.97ms ≈ 9.16 GB/s
DGX A100 的存储走 PCIe Gen4 x16,理论 32 GB/s。用 DataModel 验证:
| 指标 | 数值 |
|---|---|
| 工作负载需求 | 9.16 GB/s |
| 存储供给(PCIe Gen4 x16) | 32.00 GB/s |
| 总线利用率 | 28.6% |
| 是否阻塞 | False |
结论:存储 I/O 不是瓶颈,带宽富余 3 倍以上。流水线第一段绿灯。
四、E3:CPU 预处理——GPU 挨饿的真凶
前后两段都没问题,那瓶颈只剩 CPU。假设 8 个 worker、每个 250 MB/s,即 CPU 总共只有 2 GB/s 的预处理吞吐。用 TransformationModel 对比 CPU 变换时间和 GPU 步时间:
| 指标 | 数值 |
|---|---|
| CPU 预处理时间 | 64.0 ms |
| GPU 步时间 | 13.97 ms |
| CPU 是否瓶颈 | True |
| GPU 利用率 | 21.8% |
| 减速因子 | 4.58× |
GPU 干活只要 14ms,可 CPU 准备好下一批数据要 64ms——GPU 有 78% 的时间在空等。这就是”GPU 挨饿”:GPU 每步能处理上万个样本,但 8 个 CPU worker 只能备好不足千个。
4.1 batch 越大,饿得越狠
把 batch 从 16 扫到 1024,CPU 瓶颈被拉得更紧(CPU 吞吐固定 2 GB/s,样本变大只会让差距更大):
| Batch | GPU Step | CPU Xform | 瓶颈 | GPU 利用率 |
|---|---|---|---|---|
| 16 | 1.36 ms | 4.00 ms | CPU | 33.9% |
| 32 | 2.20 ms | 8.00 ms | CPU | 27.5% |
| 64 | 3.88 ms | 16.00 ms | CPU | 24.2% |
| 128 | 7.24 ms | 32.00 ms | CPU | 22.6% |
| 256 | 13.97 ms | 64.00 ms | CPU | 21.8% |
| 512 | 27.43 ms | 128.00 ms | CPU | 21.4% |
| 1024 | 54.34 ms | 256.00 ms | CPU | 21.2% |
4.2 加 worker,找到交叉点
那要多少个 worker 才能喂饱 GPU?扫一下(batch=512):
| Workers | CPU 吞吐 | GPU 利用率 |
|---|---|---|
| 8 | 2 GB/s | 21.4% |
| 16 | 4 GB/s | 42.9% |
| 32 | 8 GB/s | 85.7% |
| 64 | 16 GB/s | 100.0% |
| 128 | 32 GB/s | 100.0% |
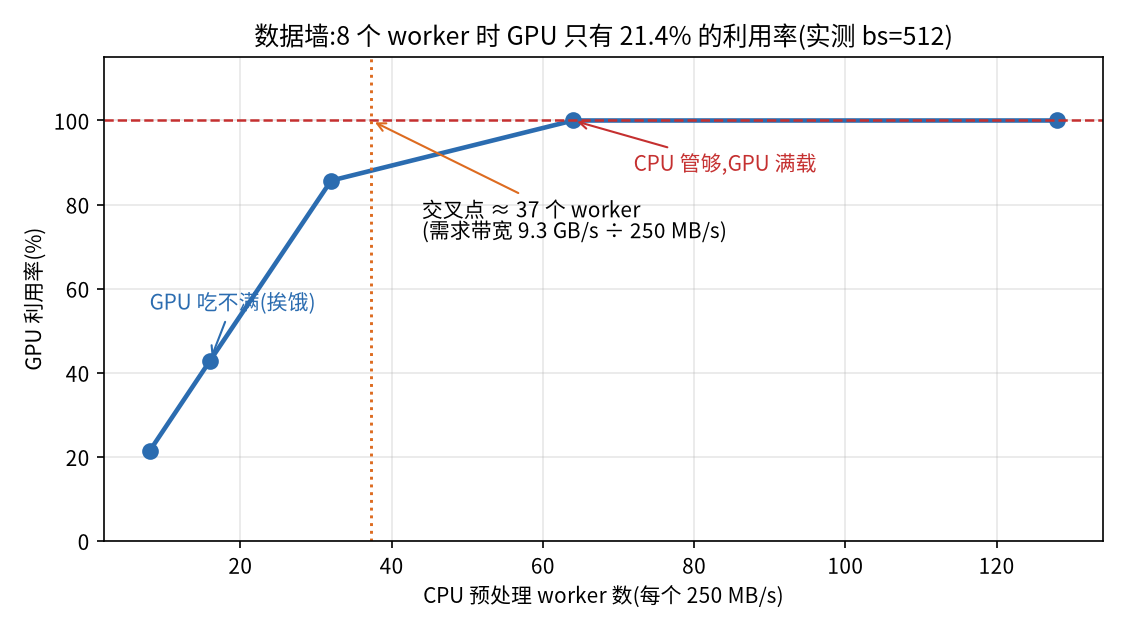
GPU 利用率几乎严格正比于 worker 数,直到撞上 100% 的天花板。交叉点可以算出来:batch=512 时需求带宽 512 × 500KB ÷ 27.43ms ≈ 9.3 GB/s,每个 worker 250 MB/s,所以:
N_workers ≥ 9.3 GB/s ÷ 250 MB/s ≈ 37 个
也就是约 37 个 worker 时 CPU 刚刚好不再拖后腿。“数据墙”这个概念的价值就在这:GPU 利用率低的时候,先检查供给端,别急着怪 GPU。
工程上消除数据墙的标准手段:加 worker、用 NVIDIA DALI 把预处理搬进 GPU、对数据集做预解码、激进预取。核心思想都一样——让 CPU 永远比 GPU 快一步。
五、E4/O1:投机解码——让 8B 给 70B”打草稿”
算法层面也有”以小博大”的机会。LLM 自回归解码是串行的:一次只生成一个 token,每步都要把整个模型权重从 HBM 读一遍(Decode 是内存受限的,见第二篇)。投机解码(Speculative Decoding)的思路是:让一个小 draft 模型先草拟 K 个 token,再用目标模型一次性并行验证,接受通过的部分。
一轮的期望产出:
E(α) = 1 + α(1-α^K)/(1-α)        # 期望接受 token 数
speedup = E(α) / (1 + K·r)        # r = draft 单 token 时间 / target 单 token 时间
关键点:target 模型验证 draft 的 K 个 token 是一次并行前向,而不是 K 次串行解码;draft 模型虽然一次也猜不了几个 token,但它便宜。于是把一次昂贵的 70B 流读摊到多个被接受的 token 上。
5.1 E4:LLaMA-3-70B 配 8B draft
用 ServingModel 实测(H100,seq_len=2048,batch=1,α=0.75):
| 配置 | ITL | 加速比 |
|---|---|---|
| 基线(无投机解码) | 43.15 ms | 1.00× |
| 8B draft,α=0.75 | 20.53 ms | 2.10× |
E(0.75)=3.05:平均每轮草拟 4 个、接受 3.05 个。校验步本质是一次 70B 的 HBM 流读(内存受限),而 8B draft 提案很便宜,于是把一次流读摊到了 ~3 个被接受 token 上——2.1 倍的收益就这么来的。
5.2 O1a:接受率 α 从 0.5 扫到 0.9
| α | E(α) | 加速比 |
|---|---|---|
| 0.50 | 1.94 | 1.33× |
| 0.75 | 3.05 | 2.10× |
| 0.90 | 4.10 | 2.82× |
接受率越高收益越陡——draft 猜得越准,一轮摊掉的流读成本越多。
5.3 O1b:draft 模型该多大?实测推翻了一个常见直觉
用不同尺寸的 draft 模型跑(α 固定 0.75):
| Draft 模型 | 参数量 | 加速比 |
|---|---|---|
| GPT-2 | 1.5B | 2.77× |
| Llama-3-8B | 8B | 2.10× |
| Llama-3-70B | 70B(=target) | 0.62× |
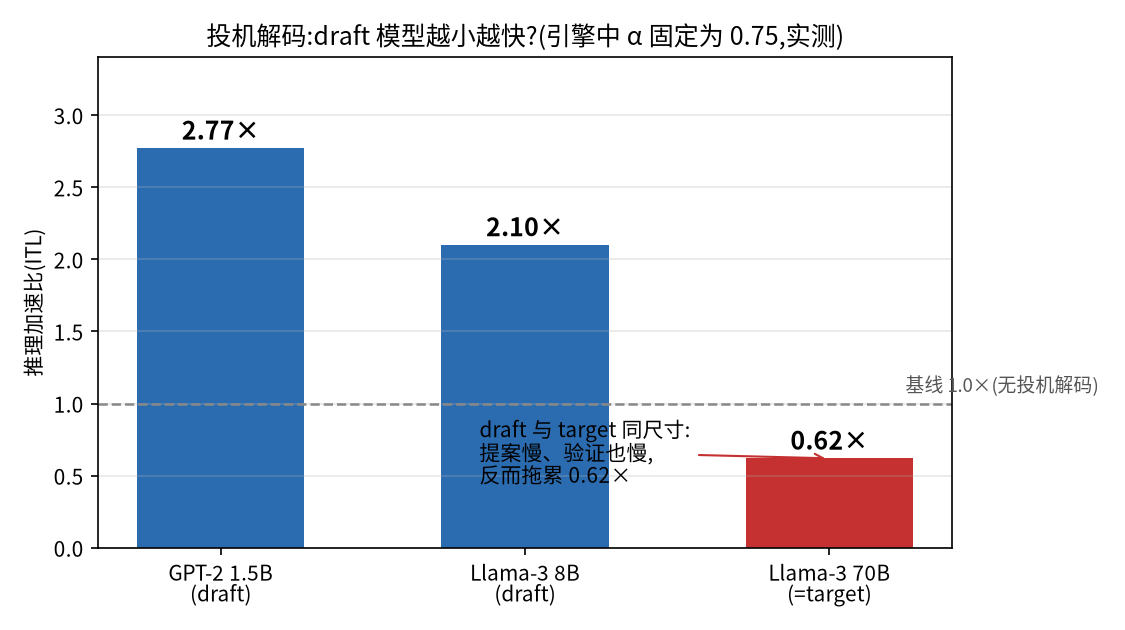
这里和常见说法(“draft 太小→接受率低,draft 太大→开销爆炸,8B 是折中的选择”)有差异:在 mlsysim 的引擎里,接受率 α 是用户直接给定的参数,它不会随 draft 模型的大小自动变化。固定 α=0.75 时,更小的 draft 只有好处没有坏处:r 更小,公式里分母更小,加速比更高——所以 GPT-2 反而最快;而 70B draft 跟 target 一样大,提案慢、验证也慢,白白多付一轮开销,跌到 0.62×(比不用还慢)。
“8B 合适”的论证其实依赖一个引擎没有建模的环节:现实中 α 是 draft 模型与 target 分布接近程度的函数——draft 太小就猜不准(α 低),draft 太大自己就慢(r 高)。引擎把 α 和模型大小解耦成独立因素,反而方便单独研究其中一个效应。真实世界的规律应该是:在”猜得准”和”跑得快”之间取折中,而引擎让你先分别理解这两个力,再自己组合。
六、E5:设计空间探索——用声明式搜索替代嵌套 for 循环
第三把尺子是系统级的。给定一个集群,在 batch_size、tensor_parallelism、pipeline_parallelism 等维度上,哪种配置吞吐最高?手写嵌套 for 循环也可以,但维度一多就乱。mlsysim 的 DSE 引擎接受一个声明式的搜索空间,自动遍历所有组合。
本次实验:Llama-3-70B,FP16,Frontier_8K 集群,搜索空间 batch_size ∈ [1024, 2048, 4096, 8192] × TP ∈ [1, 2, 4, 8] × PP ∈ [1, 2, 4],共 48 种组合,目标最大化有效吞吐:
| 排名 | TP | PP | Batch | 吞吐量 | 步延迟 |
|---|---|---|---|---|---|
| 1 | 8 | 4 | 8192 | 15,381 tok/s | 17,043 ms |
| 2 | 8 | 1 | 8192 | 15,245 tok/s | 4,299 ms |
| 3 | 8 | 2 | 8192 | 14,405 tok/s | 9,099 ms |
三个观察:
- TP=8 和 batch=8192 包揽了前三——搜索撞到了搜索空间的边界。在这个 8K-GPU 集群上,TP 越大,每张卡持有的权重越小(访存压力越小),而节点内 NVLink 通信足够快,AllReduce 的代价被摊薄;batch 越大,单次权重搬运摊到的样本越多。两个维度都是单调受益,所以最优解落在角落,而不是空间内部。
- PP 是延迟的代价:同样 TP8×batch8192,PP 从 1 提到 2,步延迟从 4.3s 翻到 9.1s;PP=4 更是 17s。流水线气泡(Pipeline Bubble)在大 batch 下虽被摊薄,但吞吐收益(15,245→15,381,仅 0.9%)远小于延迟代价。
- 一个引擎主动暴露的细节:搜索时引擎反复警告
batch_size (1024) < dp_size (8192): some ranks will be idle。Frontier_8K 有 8192 个 GPU,数据并行维度的 rank 数由集群规模自动决定——batch=8192 都只够每个 rank 分到 1 个样本(local_batch=1)。换句话说,这个集群的并行度(8K ranks)已经把单卡 batch 的空间压没了。吞吐量数字好看,但那是 8192 张卡的功劳;在集群尺度上,压住吞吐的往往是通信与并行度,而不是单卡算力。
搜索空间的设计本身也很关键:同样的问题,换一个空间(batch 从 1 到 64)结论会完全不同——最优解永远只在你画的范围内。
七、O3:推理时计算——o1 把算力需求从训练搬回推理
最后一个话题来自 Module 2 的”推理墙”(The Reasoning Wall)。o1 这类模型在回答前会先做 K 步隐藏推理(chain-of-thought),推理时计算(Inference-Time Compute)把算力需求从训练阶段搬回了推理阶段。用 InferenceScalingModel 模拟 Llama-3-8B 在 H100 上:
| K(隐藏推理步) | 总延迟 | 能耗/query | TTFT 占比 |
|---|---|---|---|
| 0(无推理链) | 0.071 s | 0.050 kJ | 100% |
| 8 | 2.15 s | 1.50 kJ | 3.3% |
| 32 | 8.38 s | 5.87 kJ | 0.8% |
两个关键观察:
- TTFT 完全不变——prefill 只处理 prompt 本身,隐藏推理是在 decode 阶段发生的。所以 K=32 时 TTFT 占比从 100% 掉到 0.8%,延迟几乎全部来自生成。
- 总延迟与能耗随 K 严格线性暴涨:K=32 时一次回答要 8.38 秒、5.87 kJ。对系统设计的影响是颠覆性的——同样的 GPU 集群只能服务 1/K 的并发。商业上”推理时计算缩放”用延迟和能耗换质量,系统上它是代价最昂贵的优化手段。
7.1 内存墙还是算力墙?我的观点和教程作者不一样
Module 2 总结页给了一个判断:“Inference shifts back toward being compute-bound as generation length dominates prefill”——推理时计算让推理从内存墙”回到”算力墙。这句话有两层意思,我同意第一层,不同意第二层。
第一层是对的:算力需求确实从训练转移到了推理。o1 把原本花在训练上的 FLOPs,变成了推理时多生成的 token。这是”推理时计算缩放”的本质,也是它对系统设计最大的冲击——容量规划从”训练集群多大”变成了”推理要烧多少 FLOPs”。
第二层我不太认同:“生成长度主导后推理变回 compute-bound”,我认为仍然卡在 decode 的内存墙上。理由有三:
- 隐藏推理 token 就是普通的自回归 decode。 K 步推理不是”更多计算”,而是”更多解码步骤”——每一步照旧是权重从 HBM 流读一遍、生成一个 token,和普通回答的生成完全同构。而 decode 是内存受限的,这在第二篇里已经实测过了(ITL 由 HBM 带宽定价)。K 步推理只是把这段内存受限的路走得更长,没有改变它的物理机制。
- 实测数据支持”内存墙”而不是”算力墙”。 如果瓶颈真的变成了算力,我们应该看到 prefill 式的机制变化;但实测里 (a) 唯一一段算力受限的环节——prefill(TTFT)——完全没动;(b) 总延迟随 K 严格线性,每步代价恒定,这正是”每个 token 都由 HBM 流读定价”的特征,而不是算力受限的特征。
- 作者的观点在什么条件下才成立?大批量服务。 Decode 的算术强度随 batch 上升(见第二篇的 roofline 分析):并发足够大时,GPU 算力被充分占用,decode 确实会从内存受限转向算力受限。但那是”系统吞吐”意义上的转变;单请求、低并发下,推理时计算只是”更长的 decode”,依然是内存墙。这和第三篇 KV-Cache 的结论是同一个硬币的两面:长序列的成本由内存定价,而不是由算力定价。
八、个人思考:三把尺子与”先找瓶颈”
Task 4 把前三篇的单点技能收束成一套方法论,我理解成三把尺子:
- 供给端(数据墙):吞吐上不去先看流水线最窄环节,GPU 利用率低 ≠ GPU 不行;
- 算法端(投机解码):不换硬件也能加速——用小模型提案、目标模型验证,把串行解码摊成并行验证;
- 搜索端(DSE):配置空间太大时别靠经验拍脑袋,声明式搜索自动找最优解。
这套方法最有价值的部分不是任何一个公式,而是“先找瓶颈,再优化”的顺序。E3 里 4.58× 的减速、E4 里 2.10× 的加速、E5 里边界解的出现,都是先定位约束再动手的结果。反过来,在不清楚瓶颈的情况下盲目优化,很容易在非瓶颈环节上浪费力气——就像给存储加 NVMe,而真正的瓶颈在 CPU 预处理。
另外一个体会来自 5.3 节:draft 大小的实测和常见直觉不一致,不是谁对谁错,而是建模粒度不同。引擎把 α 当作独立参数,现实里 α 依赖 draft 质量。读引擎源码、看清它把哪些东西解耦,比背结论更能预测”换个条件会怎样”。
九、参考资料与复现
- 教程链:00 Hello Roofline(第一篇)→ 01 Memory Wall + 02 Two Phases(第二篇)→ 03 KV-Cache(第三篇)→ 04 Starving the GPU+ 12 Design Space Exploration+ Module 2(本篇)。
- 打卡任务:Datawhale llm-algo-leetcode #136。
- 复现方法:
pip install mlsysim,三个脚本见文末附录,均可直接运行(E1-E3、E4/O1/O3 不依赖集群;E5 使用内置集群 Frontier_8K,见mlsysim.Systems.Clusters)。 - 环境:WSL2 + conda 环境 mlsysim(python 3.11,mlsysim 0.1.1),全程无 GPU,纯仿真。
附:完整运行脚本(可直接复制运行)
脚本 1:E1-E3 数据流水线分析
import mlsysim
from mlsysim.solvers import SingleNodeModel, DataModel
from mlsysim.solvers import TransformationModel

from mlsysim.solvers import SingleNodeModel
from mlsysim.core.units import Q_
from mlsysim.show import table, info

model = mlsysim.Models.Vision.ResNet50
hardware = mlsysim.Hardware.Cloud.A100
solver = SingleNodeModel()

# Baseline: ResNet-50 on A100, batch 256, FP16
profile = solver.solve(model=model, hardware=hardware, batch_size=256, precision="fp16")

info("GPU Compute Baseline",
     Model=model.name,
     Hardware=hardware.name,
     Batch_size=256,
     Step_latency=profile.latency.to('ms'),
     Throughput=f"{profile.throughput:.0f} img/s",
     Bottleneck=profile.bottleneck)

from mlsysim.solvers import DataModel

sample_size = Q_("500 KB")  # Average ImageNet JPEG
batch_size = 256

# Data demand = batch_size x sample_size / step_time
step_time_s = profile.latency.to("s").magnitude
data_per_step = (batch_size * sample_size.to("GB")).magnitude
demand_rate = Q_(data_per_step / step_time_s, "GB/s")

data_solver = DataModel()
data_result = data_solver.solve(workload_data_rate=demand_rate, hardware=hardware)

info("Storage I/O Check",
     Data_demand=f"{demand_rate:.3f}",
     Storage_supply=f"{data_result.supply_bw:.2f}",
     Utilization=f"{data_result.utilization:.1%}",
     Is_stalled=data_result.is_stalled)

from mlsysim.solvers import TransformationModel

transform_solver = TransformationModel()
cpu_throughput = Q_("2 GB/s")  # 8 workers x 250 MB/s each

t = transform_solver.solve(
    batch_size=256,
    sample_size_bytes=sample_size,
    cpu_throughput=cpu_throughput,
    accelerator_step_time=profile.latency
)

info("CPU vs GPU Pipeline",
     CPU_transform_time=t.transform_time,
     GPU_step_time=t.accelerator_step_time,
     CPU_is_bottleneck=t.is_bottleneck,
     GPU_utilization=f"{t.accelerator_utilization:.1%}",
     Slowdown_factor=f"{t.slowdown_factor:.2f}x")

rows = []
for bs in [16, 32, 64, 128, 256, 512, 1024]:
    p = solver.solve(model=model, hardware=hardware, batch_size=bs, precision="fp16")

    t = transform_solver.solve(
        batch_size=bs,
        sample_size_bytes=sample_size,
        cpu_throughput=cpu_throughput,
        accelerator_step_time=p.latency
    )

    binding = "Transformation" if t.is_bottleneck else p.bottleneck
    rows.append([
        bs,
        f"{p.latency.to('ms').magnitude:.2f} ms",
        f"{t.transform_time.to('ms').magnitude:.2f} ms",
        binding,
        f"{t.accelerator_utilization:.1%}"
    ])

table(["Batch", "GPU Step", "CPU Xform", "Binding", "GPU Util"], rows)

rows = []
for n_workers in [8, 16, 32,64, 128]:
    cpu_tp = Q_(f"{n_workers * 250} MB/s")

    p = solver.solve(model=model, hardware=hardware, batch_size=512, precision="fp16")

    t = transform_solver.solve(
        batch_size=512,
        sample_size_bytes=sample_size,
        cpu_throughput=cpu_tp,
        accelerator_step_time=p.latency
    )

    rows.append([n_workers, cpu_tp.to('GB/s'), f"{t.accelerator_utilization:.1%}"])

table(["Workers", "Throughput", "GPU Util @ bs=512"], rows)
脚本 2:E5 设计空间探索
import mlsysim
from mlsysim.engine.dse import DSE
from mlsysim.solvers import DistributedModel, EconomicsModel
from mlsysim.engine.pipeline import Pipeline

# Our fixed baseline constants
model = mlsysim.Models.Language.Llama3_70B
fleet = mlsysim.Systems.Clusters.Frontier_8K

# The evaluation function accepts a dictionary of parameters and returns a structured object
def evaluate_config(params):
    pipe = Pipeline([DistributedModel(), EconomicsModel()])

    return pipe.run(
        model=model,
        fleet=fleet,
        batch_size=params["batch_size"],
        tp_size=params["tp"],
        pp_size=params["pp"],
        precision="fp16",
        efficiency=0.45,
        duration_days=30
    )

# 1. Define the dimensions of your search grid
space = {
    "batch_size": [1024, 2048, 4096, 8192],
    "tp": [1, 2, 4, 8],
    "pp": [1, 2, 4]
}

# 2. Initialize the Design Space Explorer
dse = DSE(
    space=space,
    objective="maximize: DistributedModel.effective_throughput"
)

# 3. Search! (Tests all 4 * 4 * 3 = 48 combinations analytically)
print("Starting search...")

result = dse.search(evaluate_config)

# 4. Analyze the best configuration
best_params = result["best_params"]
best_throughput = result["best_objective"]

print(f"\nBest Configuration: TP={best_params['tp']}, PP={best_params['pp']}, Batch={best_params['batch_size']}")
print(f"Max Throughput: {best_throughput:,.0f} tokens/sec")

print(f"\nTop 3 Configurations:")
print(f"{'TP':>4} | {'PP':>4} | {'Batch':>6} | {'Throughput':>12} | {'Latency':>10}")
print("-" * 45)

for candidate in result["top_candidates"][:3]:
    p = candidate["params"]
    dist_res = candidate["result"]["DistributedModel"]

    throughput = dist_res.effective_throughput.m_as("1/s")
    latency = dist_res.step_latency_total.m_as("ms")

    print(f"{p['tp']:>4} | {p['pp']:>4} | {p['batch_size']:>6} | {throughput:>12,.0f} | {latency:>10.1f}ms")
脚本 3:E4/O1 投机解码 + O3 推理时计算
import mlsysim
from mlsysim.solvers import ServingModel, InferenceScalingModel

hw = mlsysim.Hardware.Cloud.H100
target = mlsysim.Models.Language.Llama3_70B
draft8b = mlsysim.Models.Language.Llama3_8B
draft_gpt2 = mlsysim.Models.Language.GPT2
solver = ServingModel()

# E4: 基线 vs 投机解码(8B draft, alpha=0.75)
base = solver.solve(target, hw, seq_len=2048, batch_size=1)
spec = solver.solve(target, hw, seq_len=2048, batch_size=1,
                    draft_model=draft8b, draft_acceptance_rate=0.75)
print(f"baseline ITL: {base.itl.to('ms').magnitude:.2f} ms")
print(f"spec ITL:     {spec.itl.to('ms').magnitude:.2f} ms")
print(f"speedup:      {base.itl/spec.itl:.2f}x")

# O1a: 接受率扫描
for a in [0.5, 0.75, 0.9]:
    r = solver.solve(target, hw, seq_len=2048, batch_size=1,
                     draft_model=draft8b, draft_acceptance_rate=a)
    print(f"alpha={a}: ITL {r.itl.to('ms').magnitude:7.2f} ms  speedup {base.itl/r.itl:.2f}x")

# O1b: draft 模型大小扫描
for name, dm in [("GPT2(1.5B)", draft_gpt2), ("Llama3-8B", draft8b), ("Llama3-70B", target)]:
    r = solver.solve(target, hw, seq_len=2048, batch_size=1,
                     draft_model=dm, draft_acceptance_rate=0.75)
    print(f"draft={name}: ITL {r.itl.to('ms').magnitude:7.2f} ms  speedup {base.itl/r.itl:.2f}x")

# O3: 推理时计算(K=0/8/32)
isolver = InferenceScalingModel()
for k in [0, 8, 32]:
    r = isolver.solve(mlsysim.Models.Language.Llama3_8B, hw, reasoning_steps=k)
    print(f"K={k}: total {r.total_reasoning_time.to('s').magnitude:.3f} s  "
          f"energy {r.energy_per_query.to('kJ').magnitude:.3f} kJ")
如果这篇笔记对你有帮助,欢迎交流。
-
Previous
给开源教程修了个 demoFixing a Tutorial Demo: An Open-Source PR Retrospective -
Next
GPU 为什么会挨饿:数据墙、投机解码与设计空间探索Why Does the GPU Starve: The Data Wall, Speculative Decoding, and Design-Space Exploration
If this post helped you, a coffee is always welcome ☕
